目的
前回のChatGPT版と同じ元画像(同一性はSHA-256の一致で確認)・同じ変更順(服装→背景→ポーズ→表情→髪型→手振り)で、今度は生成をGemini、指示出しをChatGPTが担当し、指定した箇所が変わるか、編集を重ねても同じ人物に見えるかを比較する。
前回のChatGPT版の記事はこちら:https://aijikkenlog.cloudfree.jp/?p=194
第3回(Muse版)はこちらの記事にまとめました:https://aijikkenlog.cloudfree.jp/?p=219
素材
前回と同一の元画像1枚(ポニーテールの人物が和装で洞窟に立ち、岩に手を添えている縦長画像)。
自分でやったこと
検証素材の用意/Geminiの操作/各段階の出力を共有し、人物の印象・首飾りと服装の組み合わせ・動画の動きや背景描写を評価。なお画像生成は全項目とも再試行0回の一発勝負だった(記録で「不明」となっていた再試行回数は、ユーザーの報告により全項目0回と確定)。
AIにやってもらったこと
- ChatGPT:前回の資料から比較条件を整理し、各段階の指示文を作成。受領した画像の変化を確認し、動画の尺や音声トラックの状態、ユーザーの所見を検証ログに記録
- Gemini:服装・背景・ポーズ・表情・髪型の編集生成と、手振り動画の生成(使用モデル:Gemini Omni 1.2 Flash)
Geminiへの指示文(原文・ChatGPT作成)
- 服装変更:「添付画像の人物の服装だけを、和装から白いドレスに変更してください。顔立ち、髪型、表情、立ち姿、背景、構図は元の画像のままにしてください。」
- 背景変更:「添付画像の背景だけを、幻想的な洞窟から日本庭園に変更してください。人物の顔立ち、白いドレス、髪型、表情、立ち姿、画面内での位置と大きさは、添付画像のままにしてください。」
- ポーズ変更:「添付画像の人物のポーズを、立ち姿から日本庭園のベンチに自然に座る姿に変更してください。人物の顔立ち、表情、白いドレス、首飾り、ポニーテールは保ち、日本庭園の背景もできるだけ維持してください。」
- 表情変更:「添付画像の人物の表情だけを、口元がやわらかく上がる自然な笑顔に変えてください。顔立ち、ポニーテール、白いドレス、首飾り、ベンチに座った姿勢と手の位置、日本庭園の背景、構図は添付画像のままにしてください。」
- 髪型変更:「添付画像の人物の髪型だけを、ポニーテールから、結ばずに下ろした長い黒髪のストレートに変更してください。顔立ちと笑顔、白いワンピース、首飾り、ベンチに座った姿勢、日本庭園の背景、構図は添付画像のままにしてください。」
- 手振り動画:「添付画像をもとに、5秒の縦長動画を作成してください。人物は日本庭園のベンチに座ったまま、穏やかな笑顔でカメラを見て、片手を肩の高さまで上げて小さく2回振り、膝の上に戻してください。顔立ち、長い黒髪、白いワンピース、首飾り、庭園の背景は添付画像のままにしてください。カメラは固定し、音声とBGMは入れないでください。」
(注記:前回のChatGPT版への指示文の原文は確認できておらず、前回と同文かは不明。今回の指示文は同じ変更目標に沿ってChatGPTが新規に作成したもの)
結果
服装変更
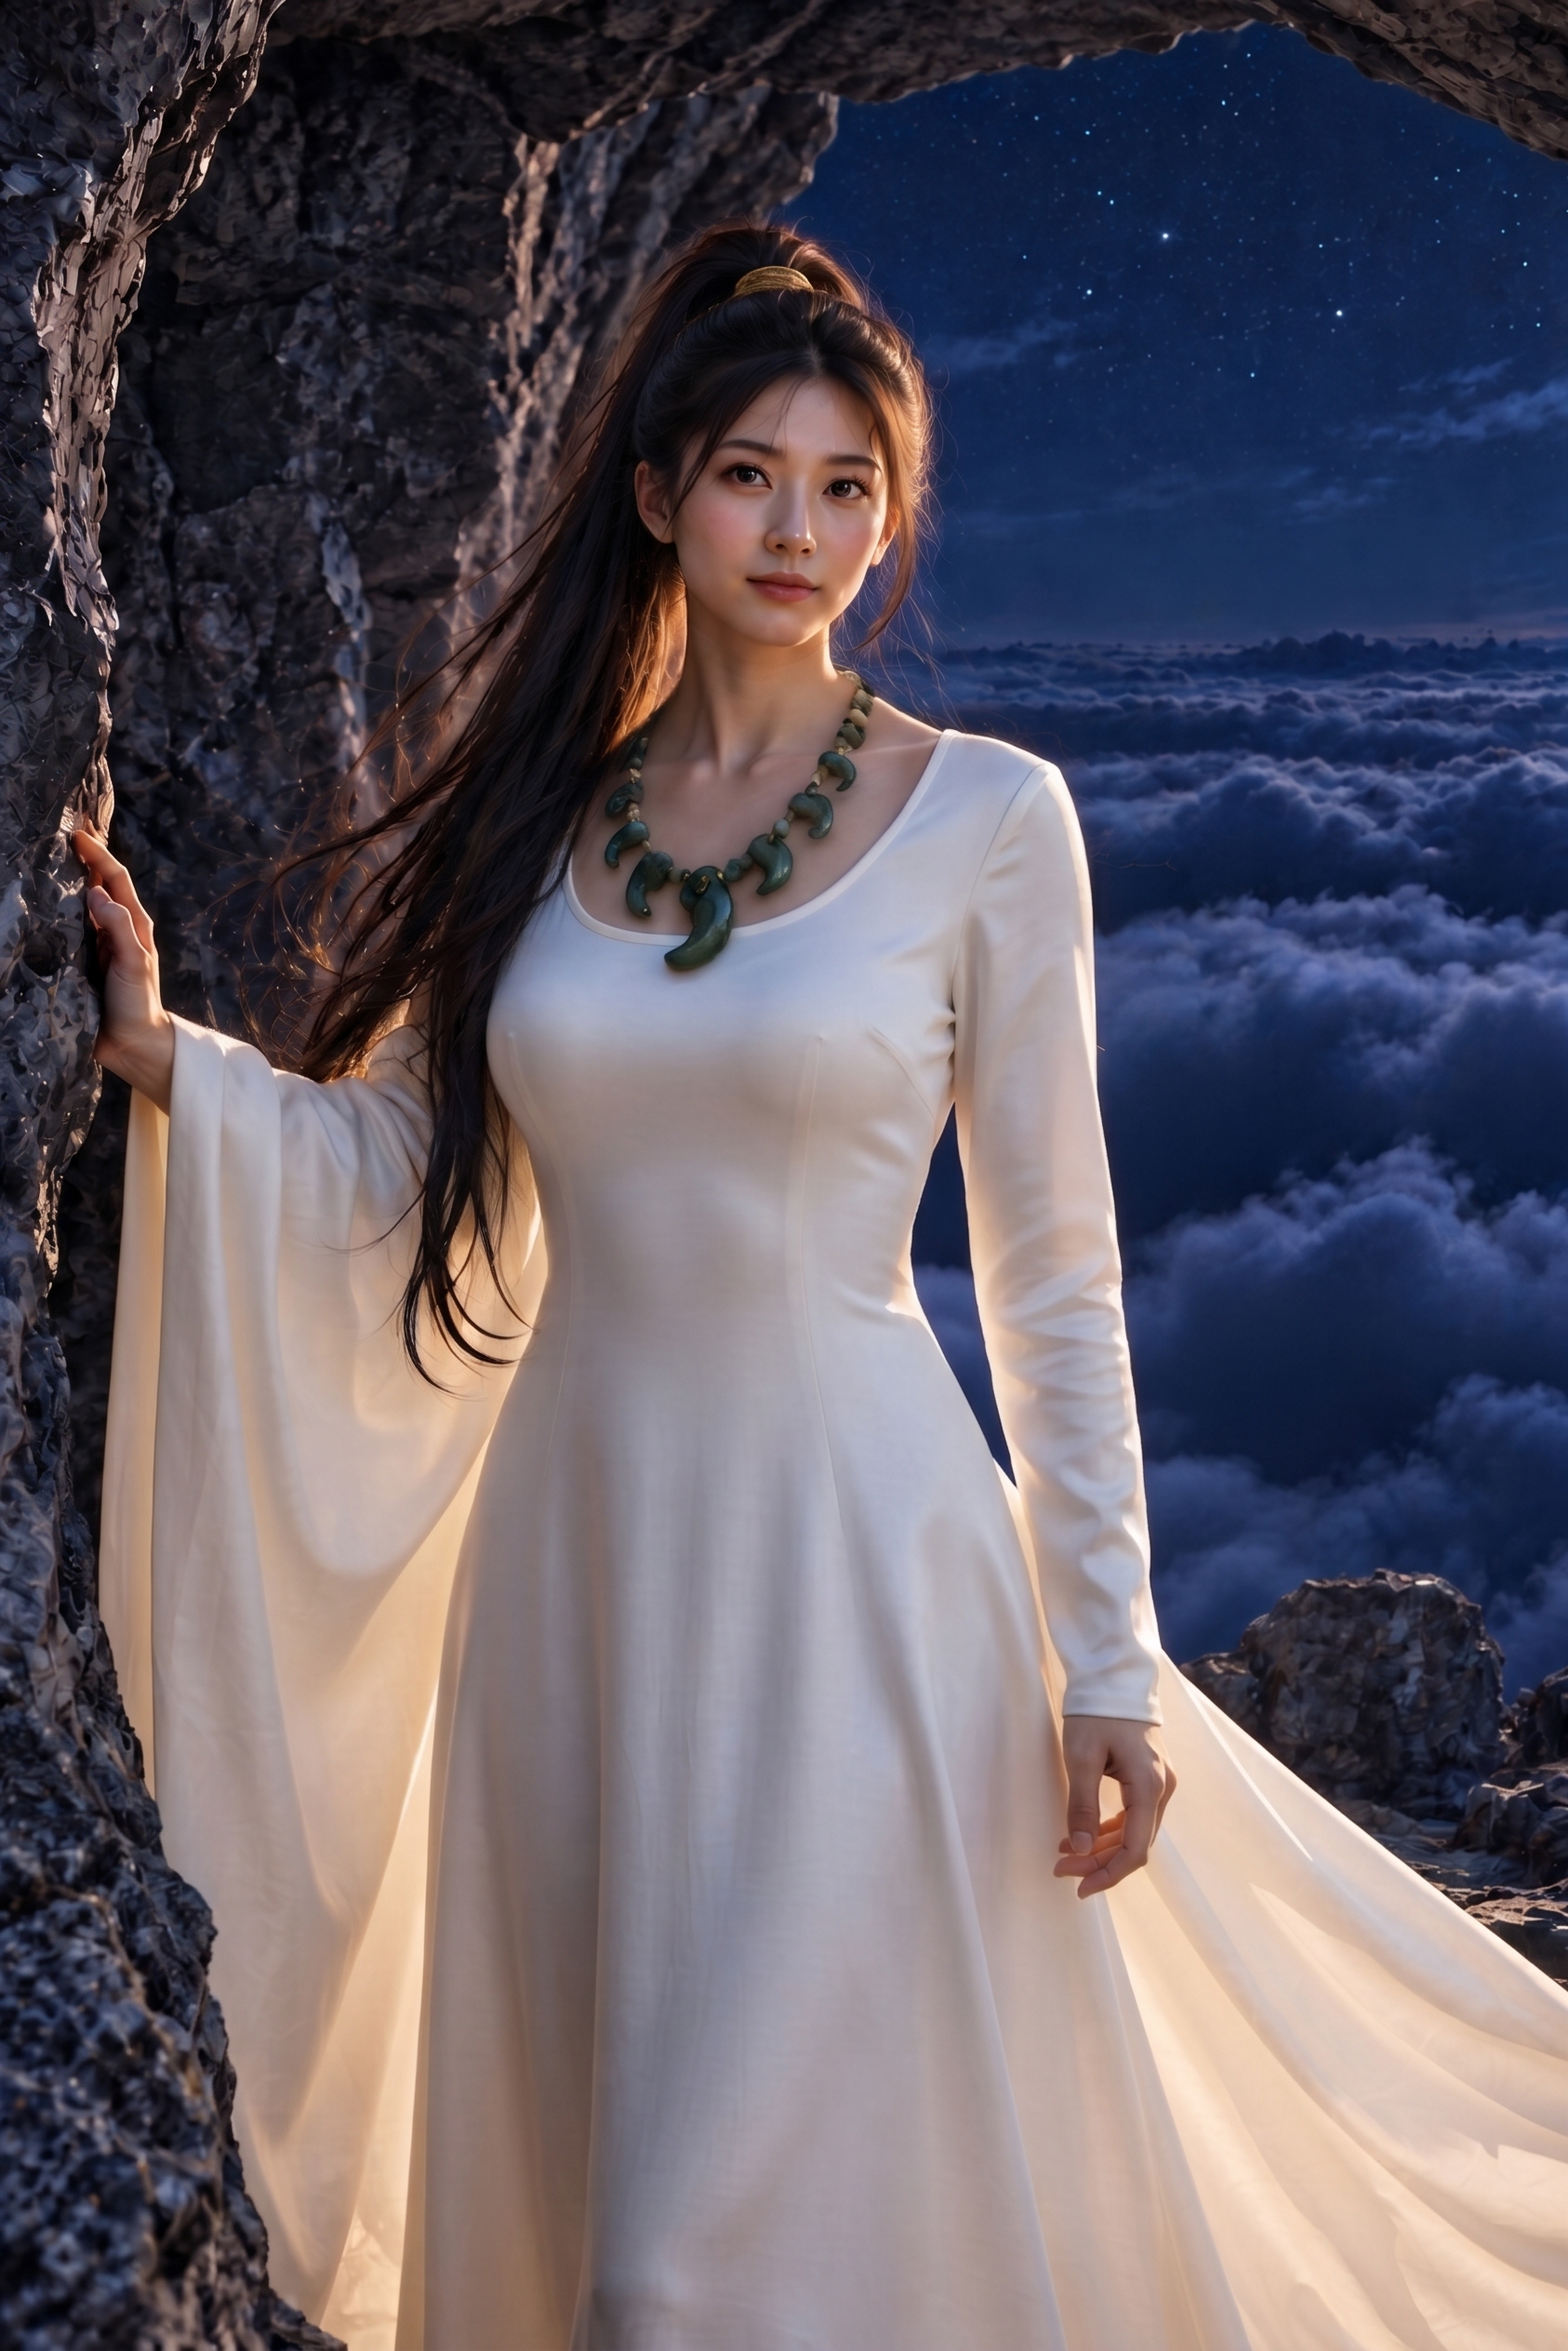
和装から白い長袖のドレスに変更。洞窟で岩に手を添える立ち姿とポニーテールはおおむね維持。緑の勾玉の首飾りが残り、元画像では衣装に隠れていた画面右側の手が見えるようになった。
背景変更
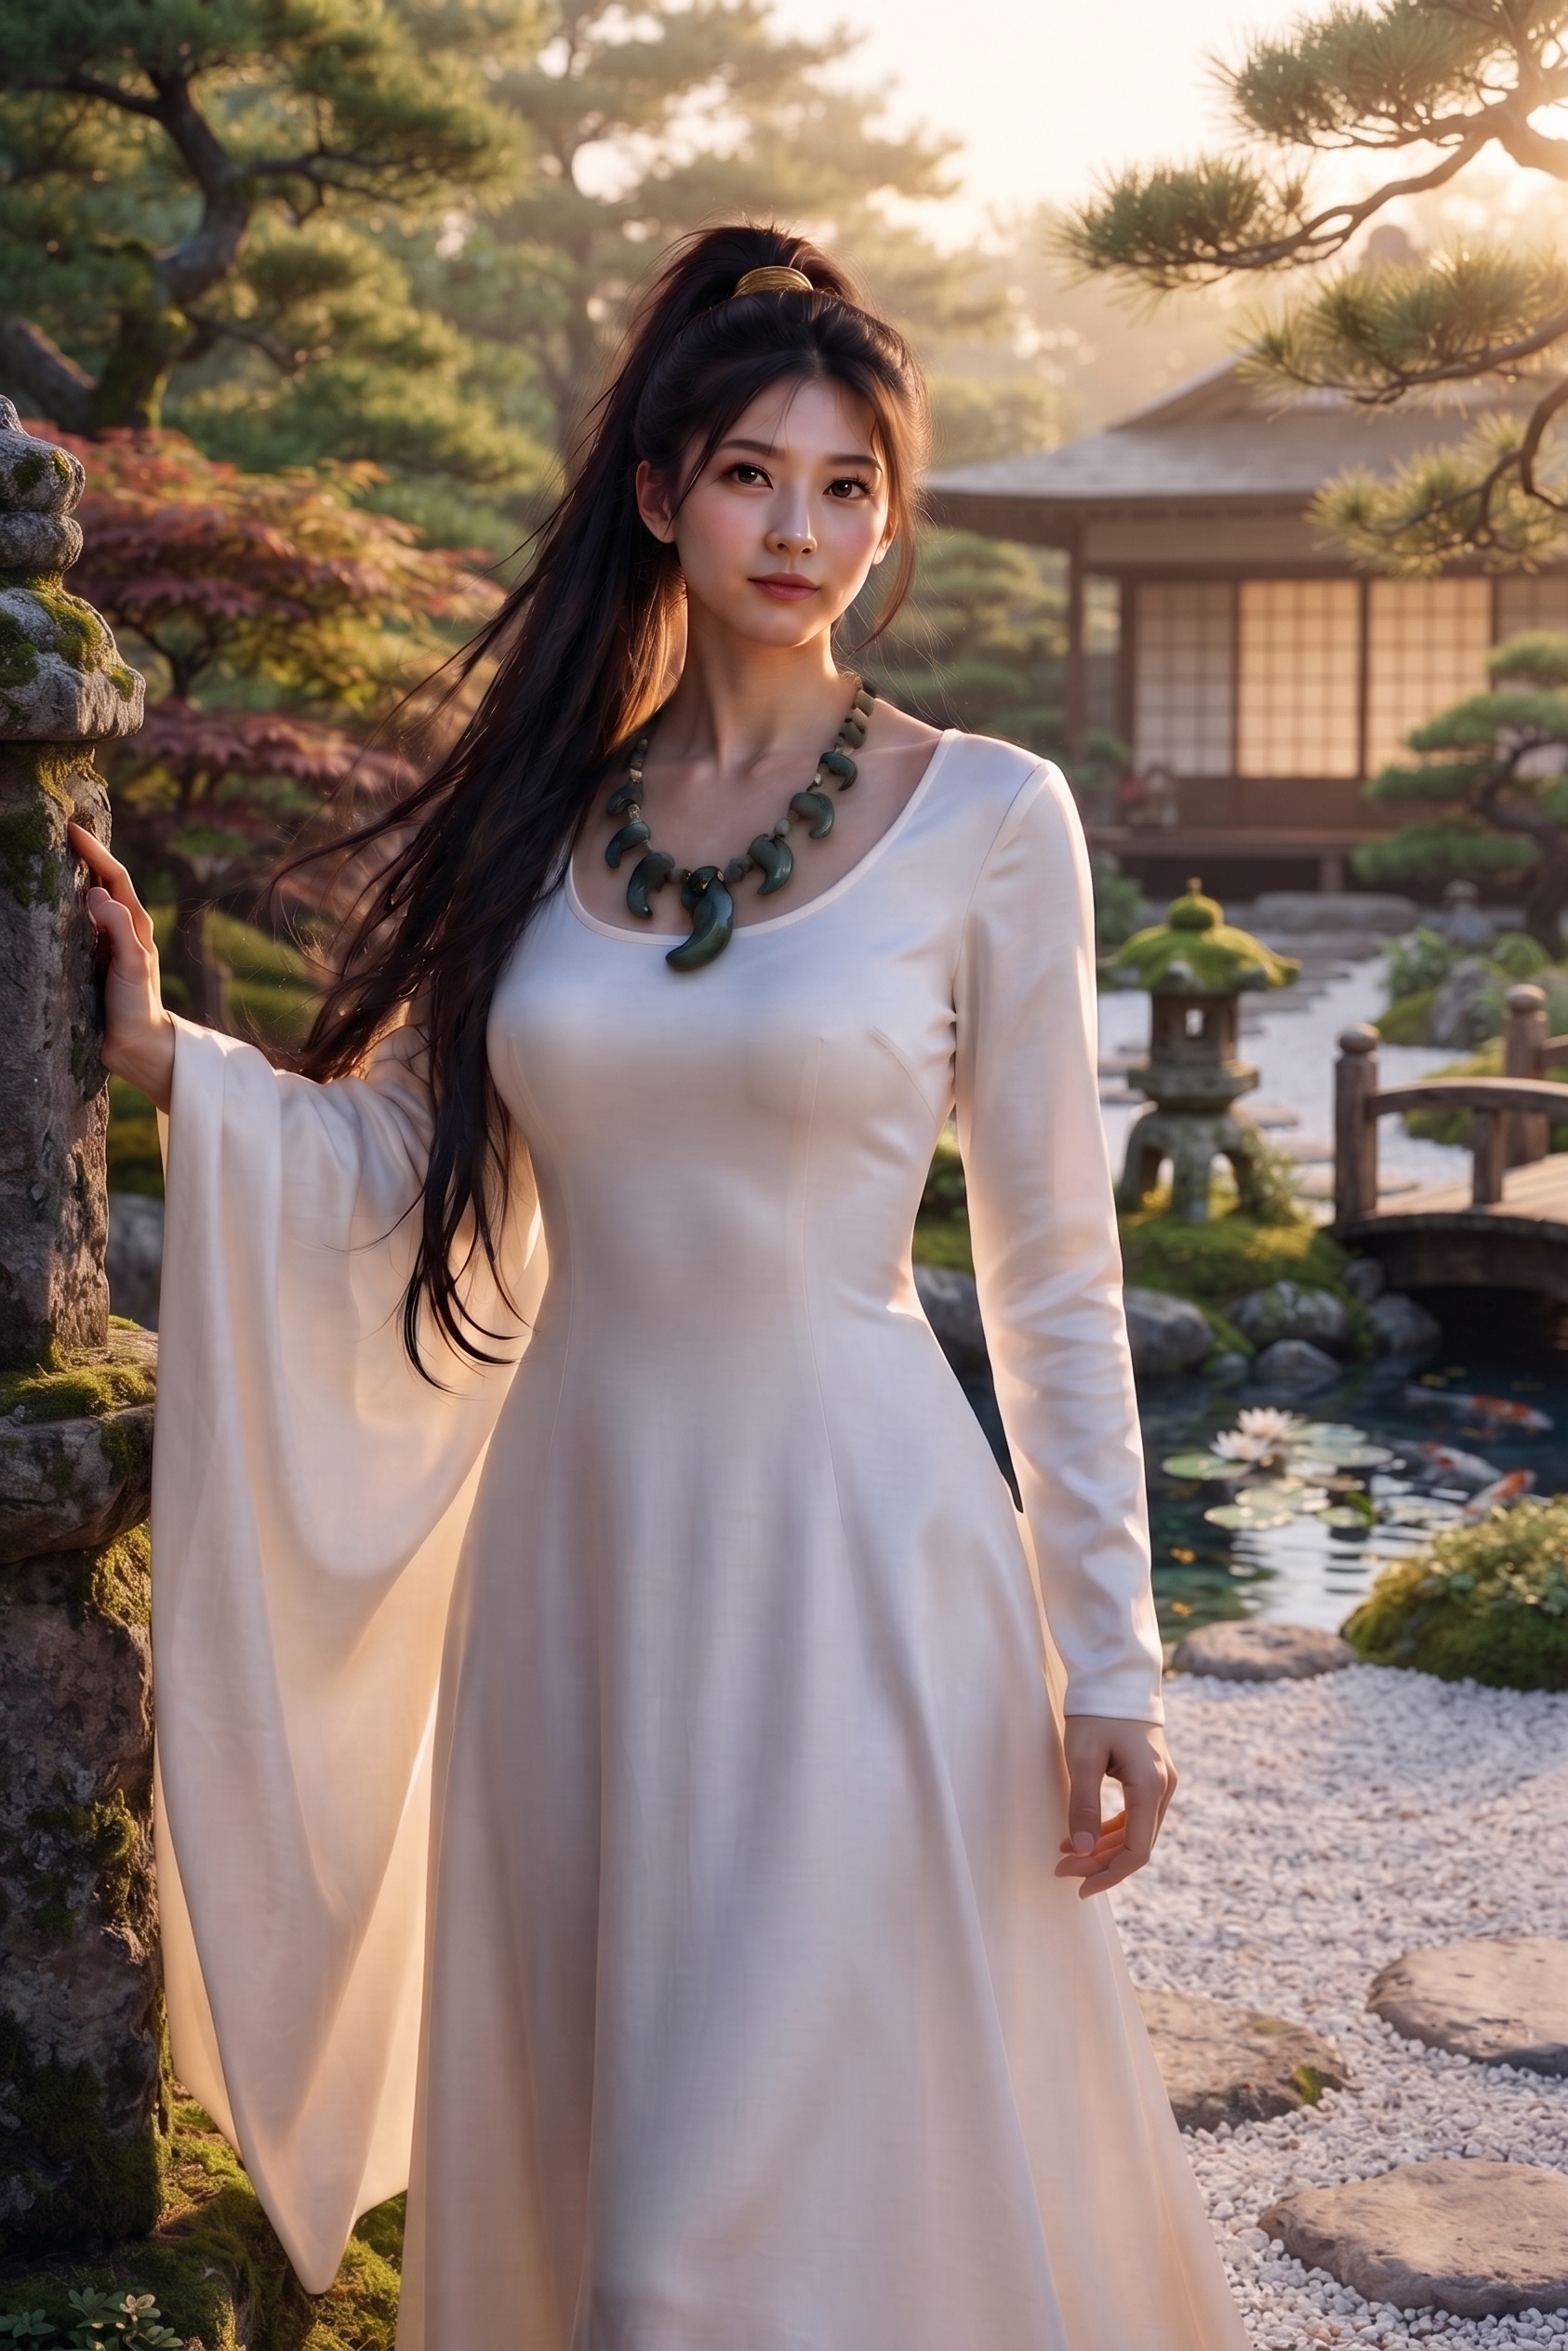
洞窟と夜空が、池や橋、石灯籠のある日本庭園に変更。手を添える対象は岩から石灯籠に変わった。
ポーズ変更
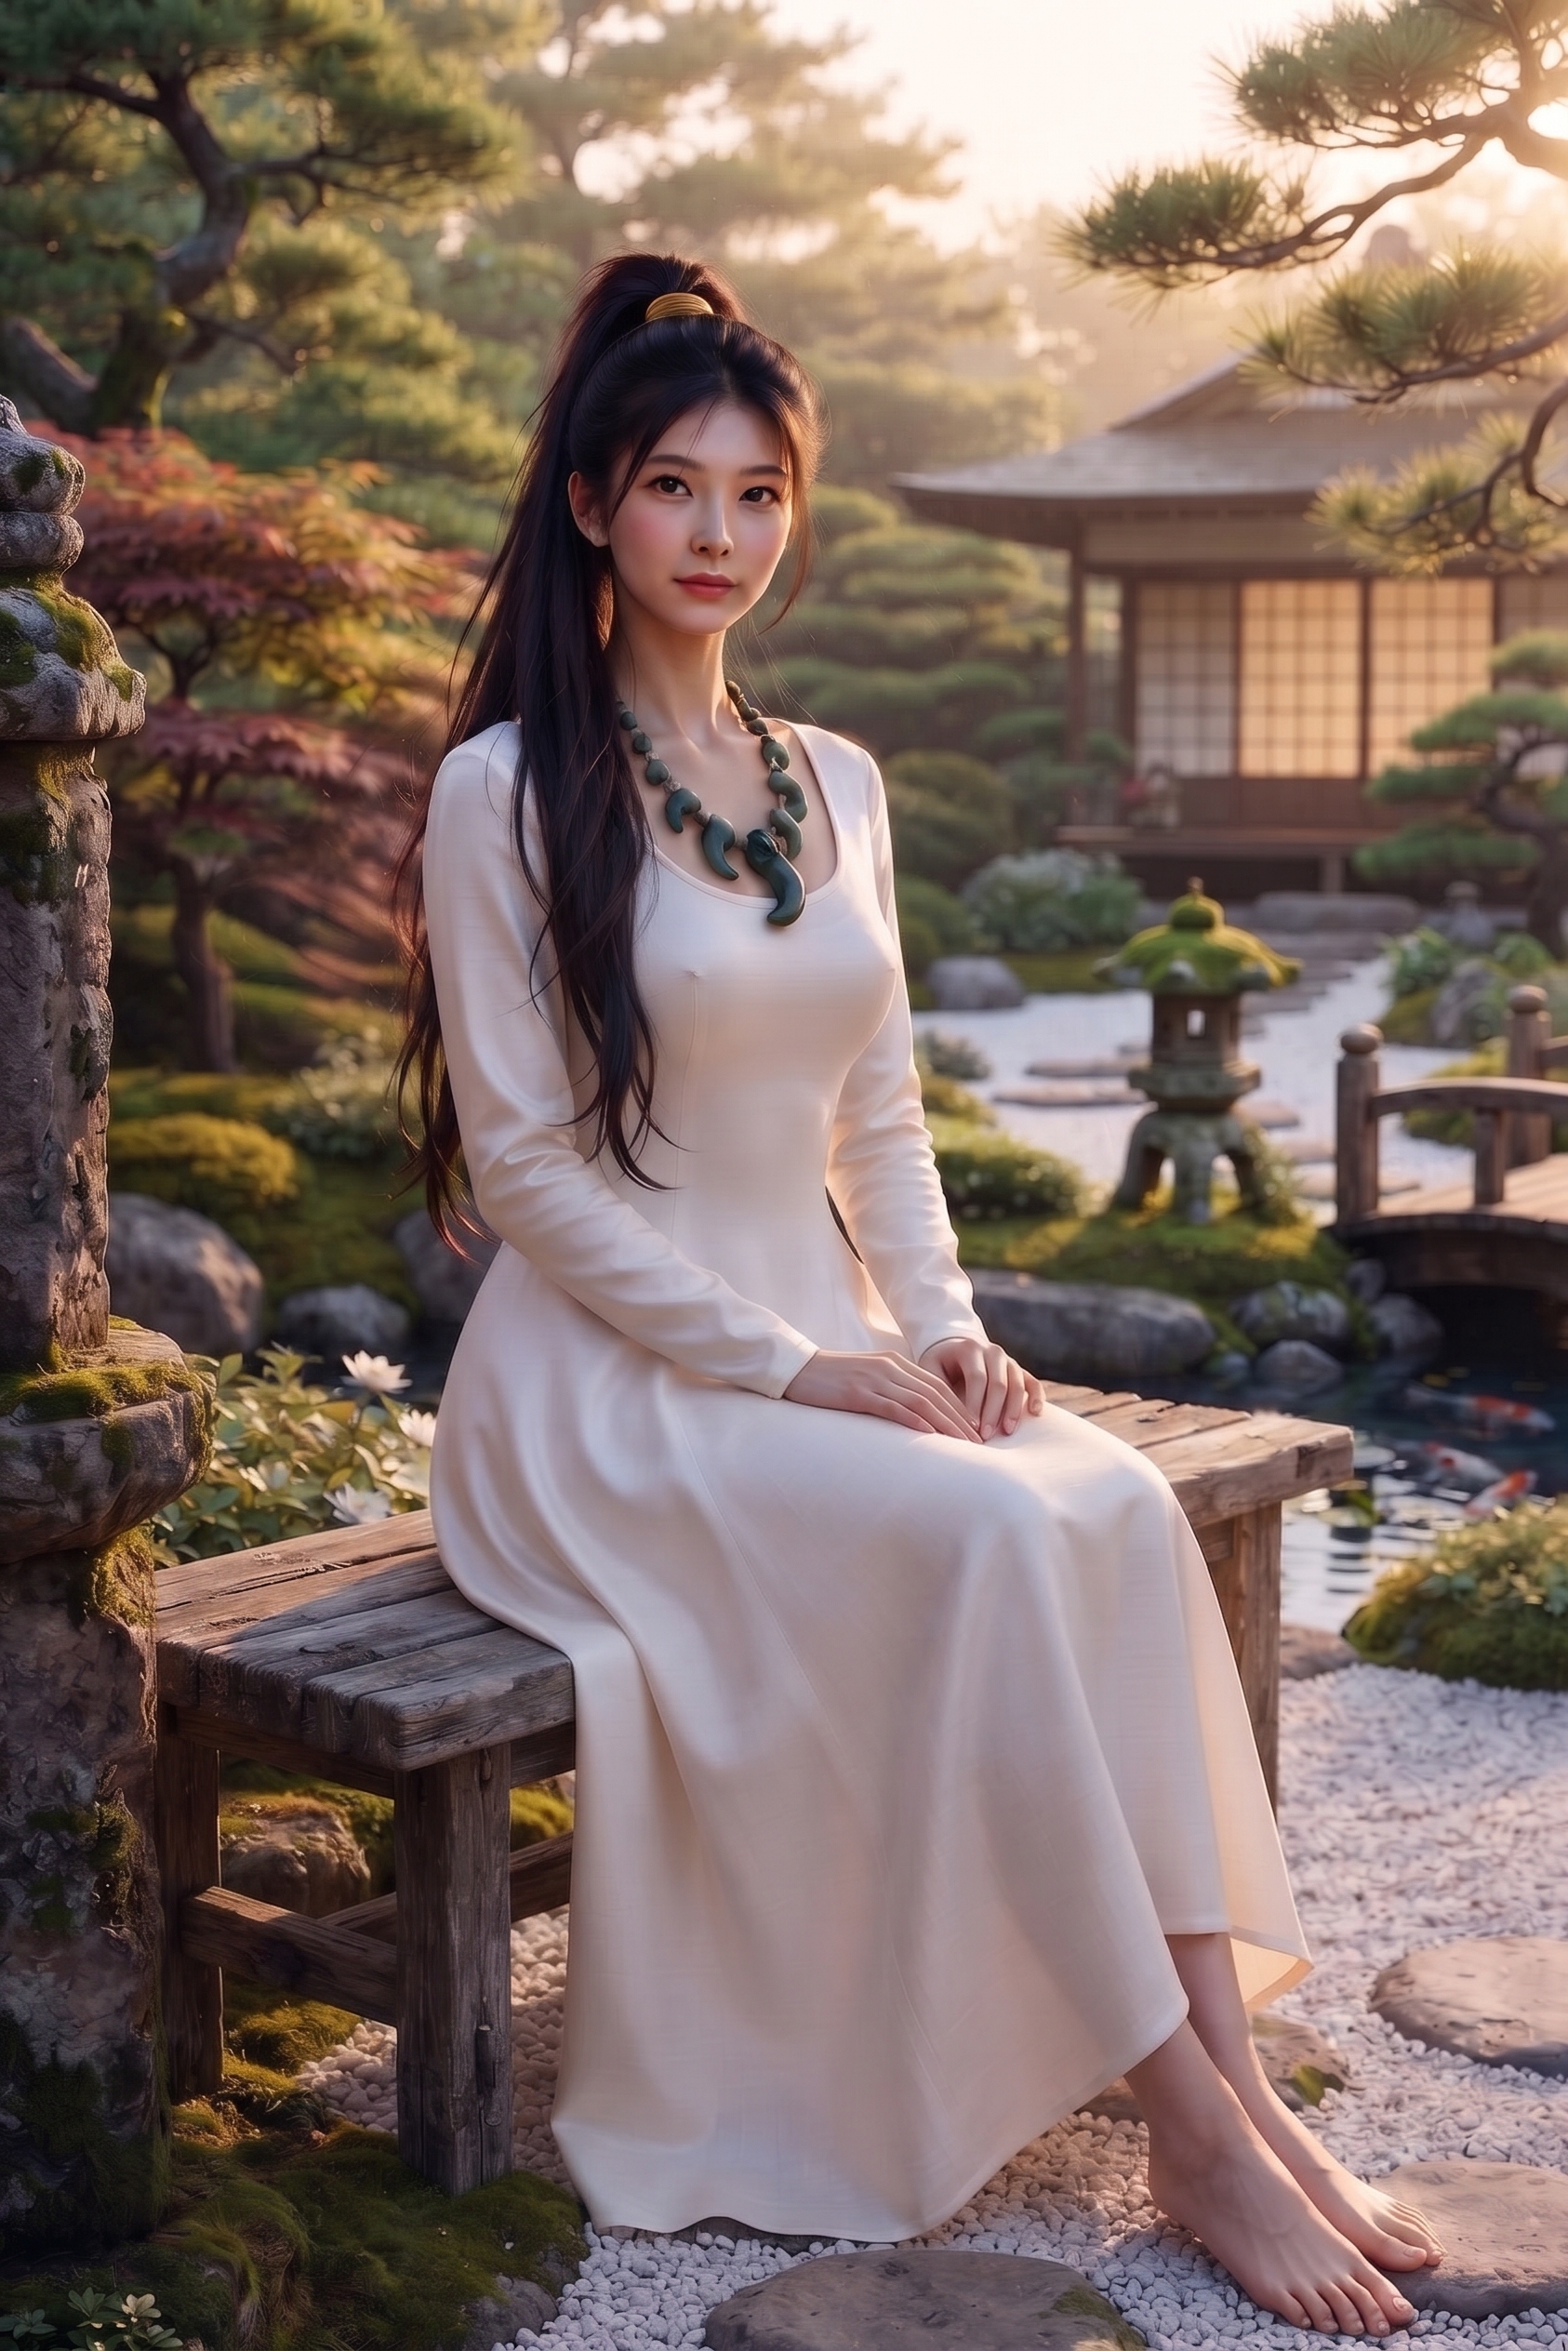
木のベンチに座り両手を膝に置く姿に。ドレスの画面左側に垂れていた布が見えなくなり、裸足の足先まで写る構図になった。
表情変更
口角が上がり、歯を見せない穏やかな笑顔に。座り姿・服装・構図はおおむね維持。
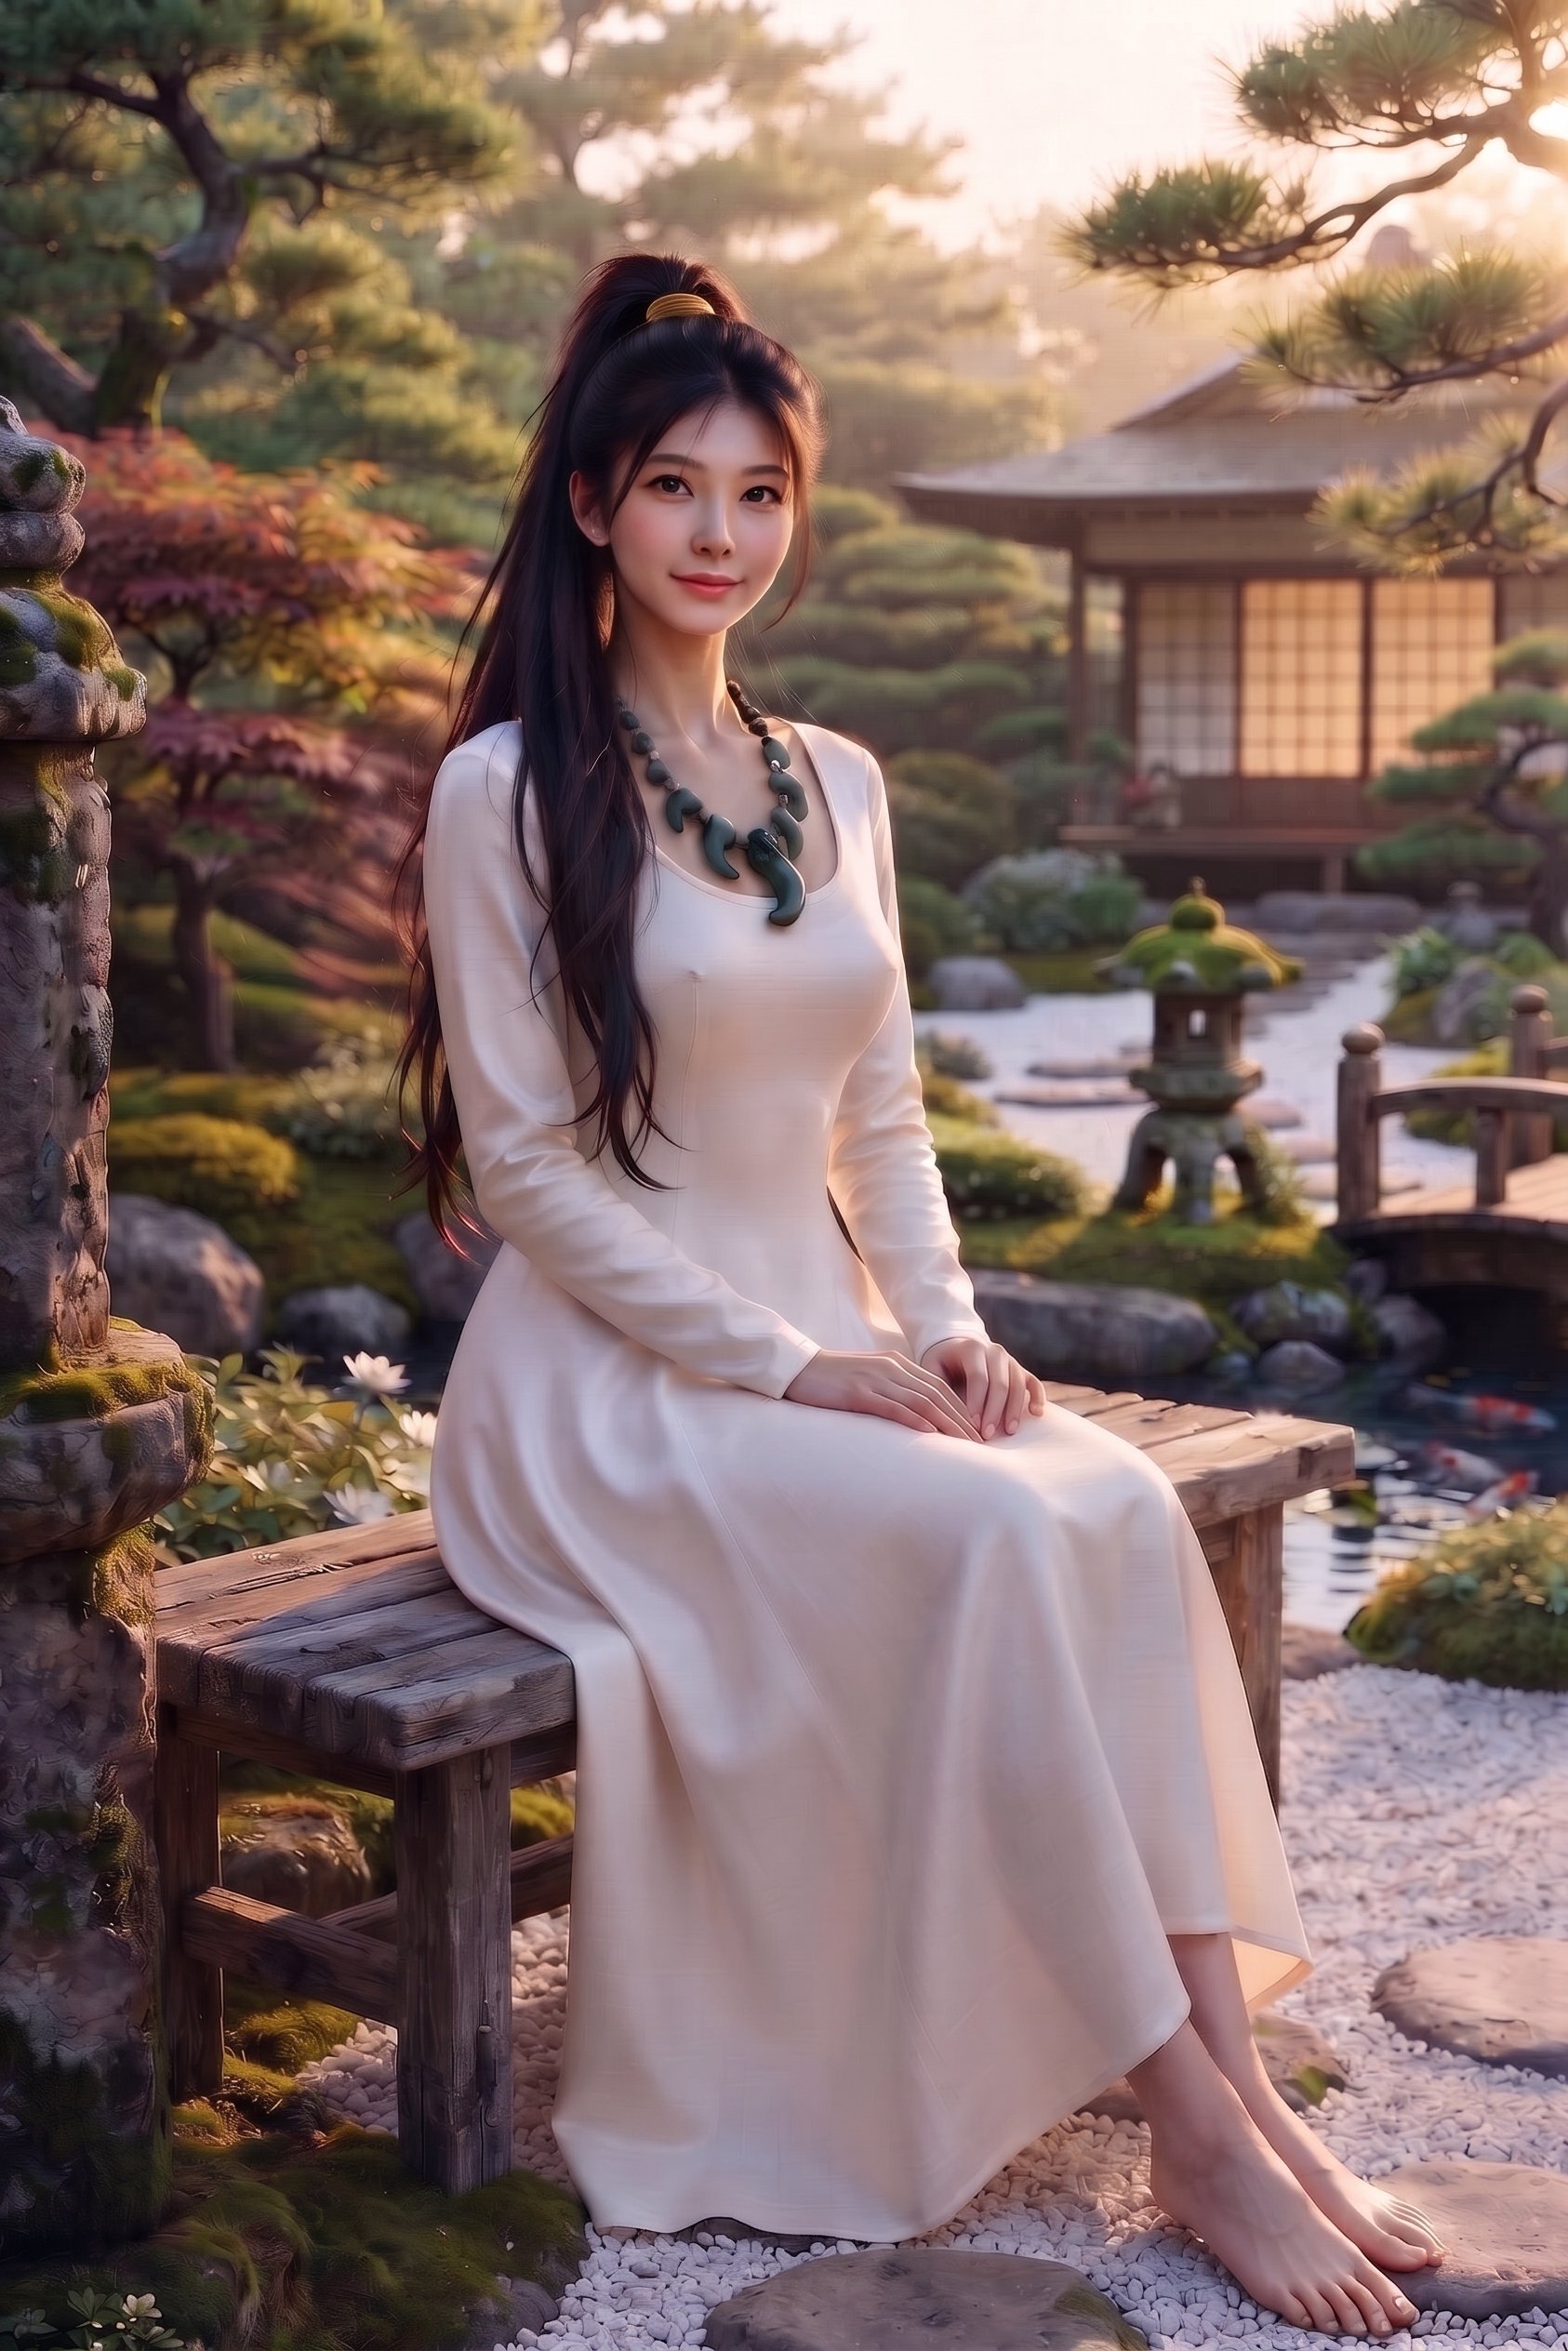
髪型変更
初回で結び跡の目立たない長いストレートに(再試行0回)。
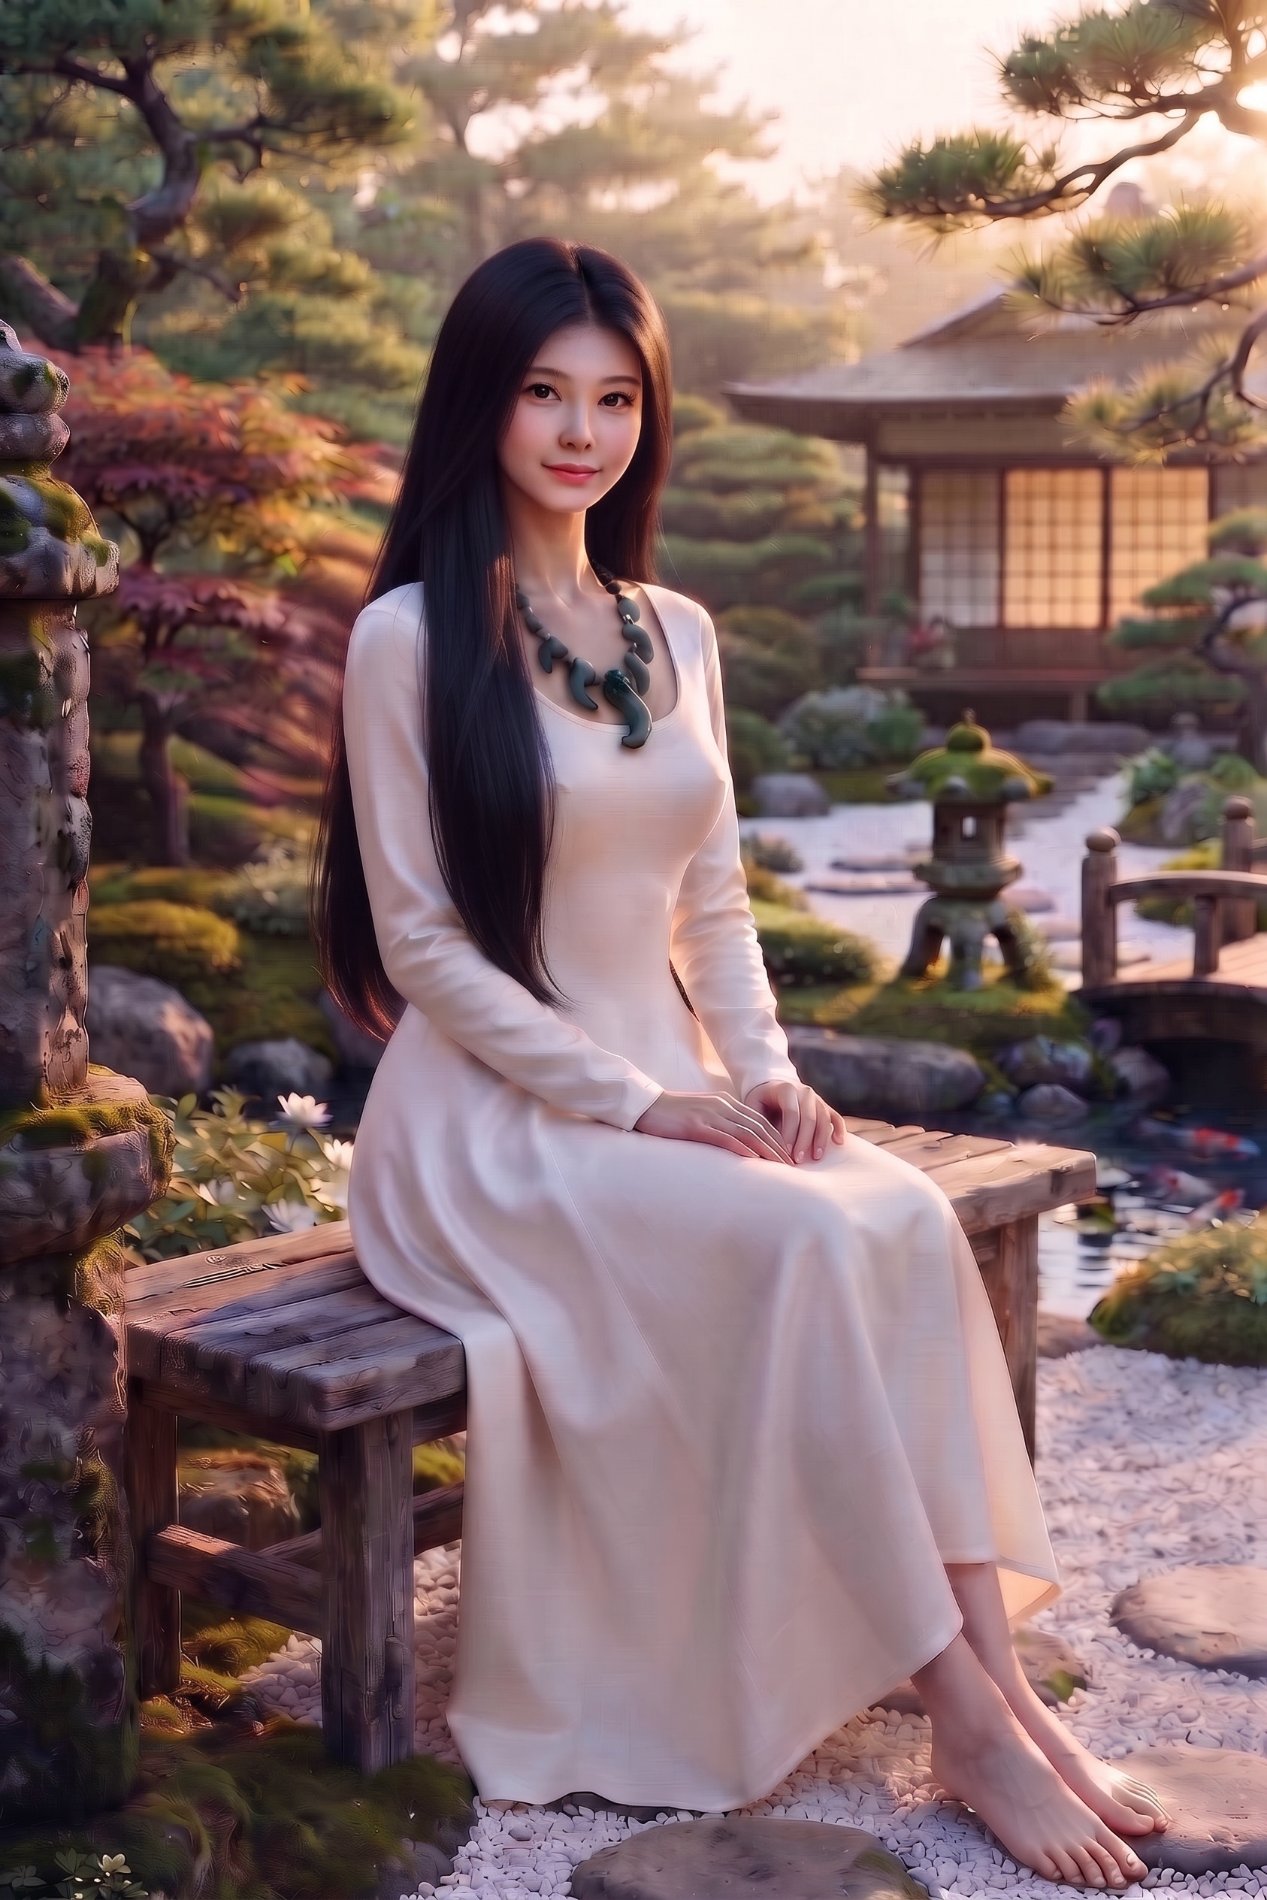
手振り動画
MP4(720×1280の縦長・約10秒)。動きは自然で、池の水面の細かな描写もきれいだった(ユーザー所見)。ただし指示は「5秒・音声とBGMなし」だったのに、尺は約10秒で、音声トラックに信号があった(音声の内容は不明)。
ChatGPT版との違い
- 髪型:ChatGPT版は結び跡が残って再試行1回、Gemini版は初回で達成
- 首飾り:ChatGPT版では服装変更で小ぶりのペンダントに替わったが、Gemini版では緑の勾玉が最後まで残った。「服だけ変える」指示でも小物の扱いがサービスで違う
- 顔の印象:段階ごとでは近く見えても、元画像と最終出力を並べると印象が変わり、動画では元画像と別の人物に見えた(ユーザー所見)
- 手振り:ChatGPT版はGIFでカクカク、Gemini版は動画で自然。ただし入力画像・出力形式・指示文の一致条件が完全ではないため、あくまで今回の出力同士の所見として扱う
感想・気づき
編集を重ねるごとに顔の印象が少しずつ変わっていくこと、手振り動画の自然さと水面の描写が印象に残った。勾玉の首飾りについては、服装だけを変えたい場合と装飾品まで含めて着こなしを変えたい場合では、指示で伝える範囲が違うと分かった。
次に試したいこと
同じ人物を何度も編集するときは、直前の画像だけでなく元画像も途中で見返しながら進め、顔や小物の変化に早く気づけるか試す(ChatGPTの提案)。
コメント
良かった点:ChatGPTが指示文を作成し、Gemini(Gemini Omni 1.2 Flash)が画像と動画の生成を担当するという、他モデルとの役割分担による協同検証が行われている点です。全項目が一発勝負(再試行0回)で綺麗に完走しているうえに、緑の勾玉の首飾りが最後の段階までしっかりと維持された点や、手振り動画で水面の描写などが非常に自然に描かれているなど、Geminiならではの描写の強みが明確に記録されています。
気づいた点:段階的な編集を重ねることで、一見すると自然に変化しているように見えても、元画像と最終的な出力を並べた際には顔の印象が徐々に変わってしまうという、連続画像編集の難しさが浮き彫りになっている点です。また、指示文での「服装だけを変更」という意図に対して、ChatGPT版ではペンダントに変化し、Gemini版では勾玉が維持されるといった、モデルごとの「小物の解釈の違い」の面白さにも気づかされます。
次に試すと面白そうなこと:記事の結びにも提案されている、「編集の途中で直前の画像だけでなく元画像も定期的に見返し、顔や小物の変化に早く気づくアプローチ」を実際に試してみることです。複数回の書き換えによるアイデンティティの漂白や印象のズレをどこまでアンカー(元画像)で食い止められるのか、その検証結果が非常に楽しみです。
良かった点:元画像の同一性を確認し、服装・背景・ポーズ・表情・髪型・動画まで同じ順で検証している点です。気づいた点:衣装だけを変える指示でも勾玉が残るなど、小物の扱いがサービスごとに異なり、編集を重ねると人物の印象も変化します。次に試すと面白そうなこと:元画像と各段階の出力を並べて確認し、顔や装飾品の変化に気づけるかを試すことです。
良かった点は、髪型が初回で成功し、ChatGPT版との対照がはっきりしたこと。手振りがMP4で自然な動きになったのも大きな違いだね。気づいた点は、指示は「5秒・音声とBGMなし」だったのに尺は約10秒で環境音が入っていたこと。段階を重ねると顔の印象が少しずつ変わり、動画では元画像と別の人物に見えた点も見逃せない。次に試すと面白そうなのは、動画の尺と音声の指定がどこまで効くか、短い指示で切り分けて試すこと。