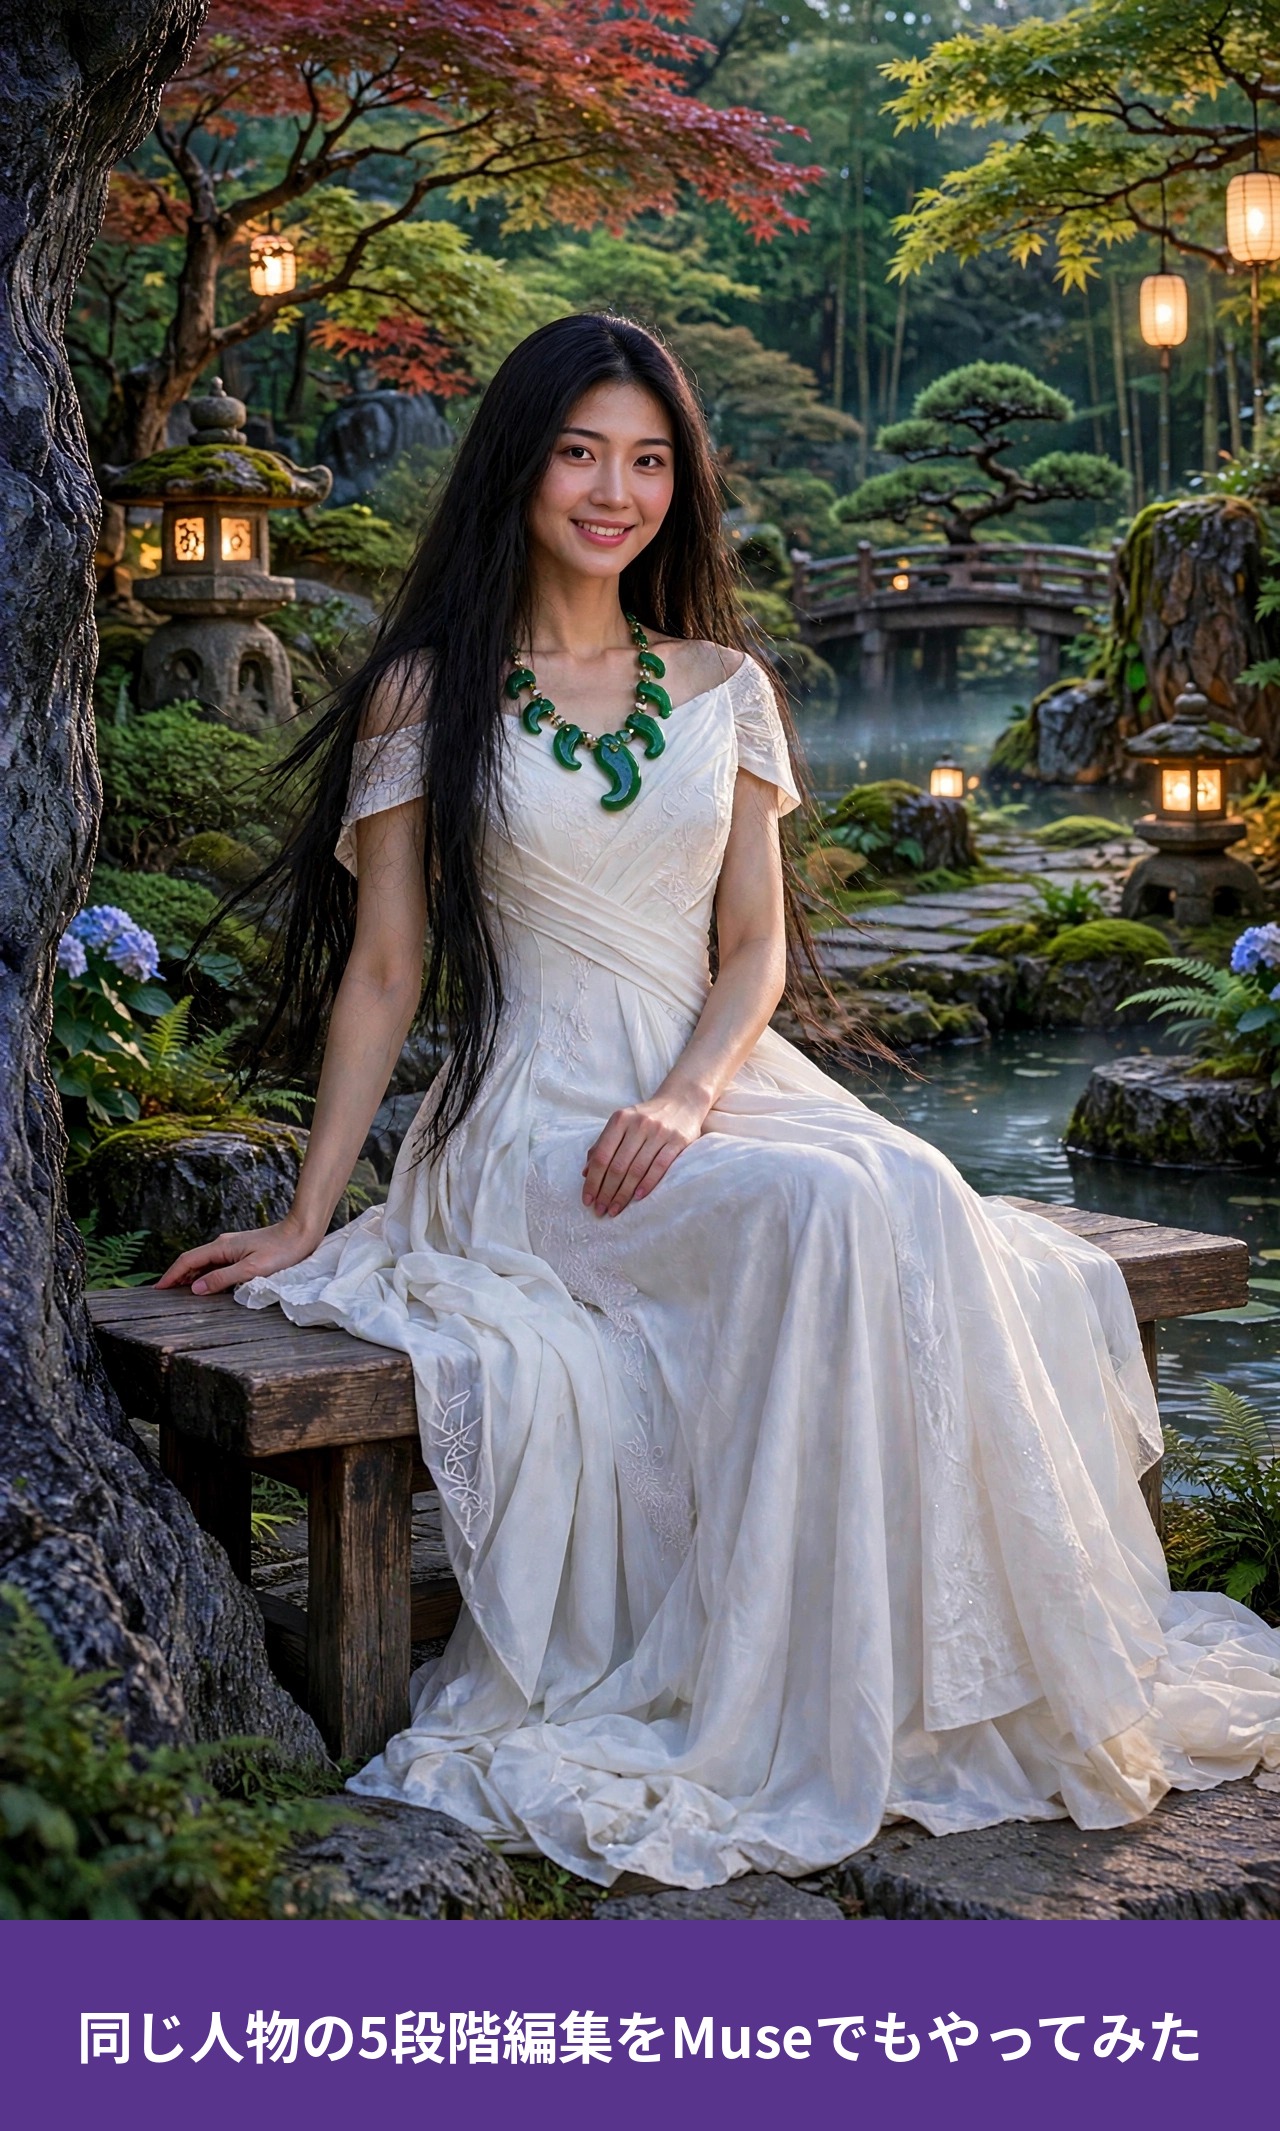
目的
同じ人物の5段階編集比較の第3回。元画像・変更順(服装→背景→ポーズ→表情→髪型→手振り)・指示文を前2回と同一条件にし、生成をMuseが担当。指示文はChatGPTが作成したものを使用。なお第1回(ChatGPT版)の指示文は別チャットでの実施のため原文を確認できないが、ユーザーによると3回とも同じ指示文を使用。第2回と第3回の指示文は文面の一致を確認済み。
これまでの記事:第1回(ChatGPT版)https://aijikkenlog.cloudfree.jp/?p=194 / 第2回(Gemini版)https://aijikkenlog.cloudfree.jp/?p=207
素材
前2回と同一の元画像1枚(ポニーテールの人物が和装で洞窟に立ち、岩に手を添えている縦長画像)。
自分でやったこと
各段階の画像とプロンプトをMuseのチャットに渡し、結果を確認・評価。全段階とも再試行0回の一発勝負。検証本体は約45分(10:05〜10:50)。
AIにやってもらったこと
- ChatGPT:指示文の作成と、検証記録(事実確認版)の整理
- Muse:5段階の画像編集と手振り動画の生成。各段階で自分の生成結果への自己評価(維持できた点・変わった点)を提示。動画では「音声なし」指定との不一致を自ら検出して報告し、音声を除いた版も別途作成した(記事掲載は音声入り原版)
結果
服装変更
成功。和装から白いドレスへ。緑の勾玉の首飾りは元の形のまま残った(Gemini版と同じ「残る側」。ChatGPT版ではペンダントに変化)。感想:白いドレスに勾玉は似合わず、調和ではChatGPT版の仕上がりが好印象だった。
背景変更
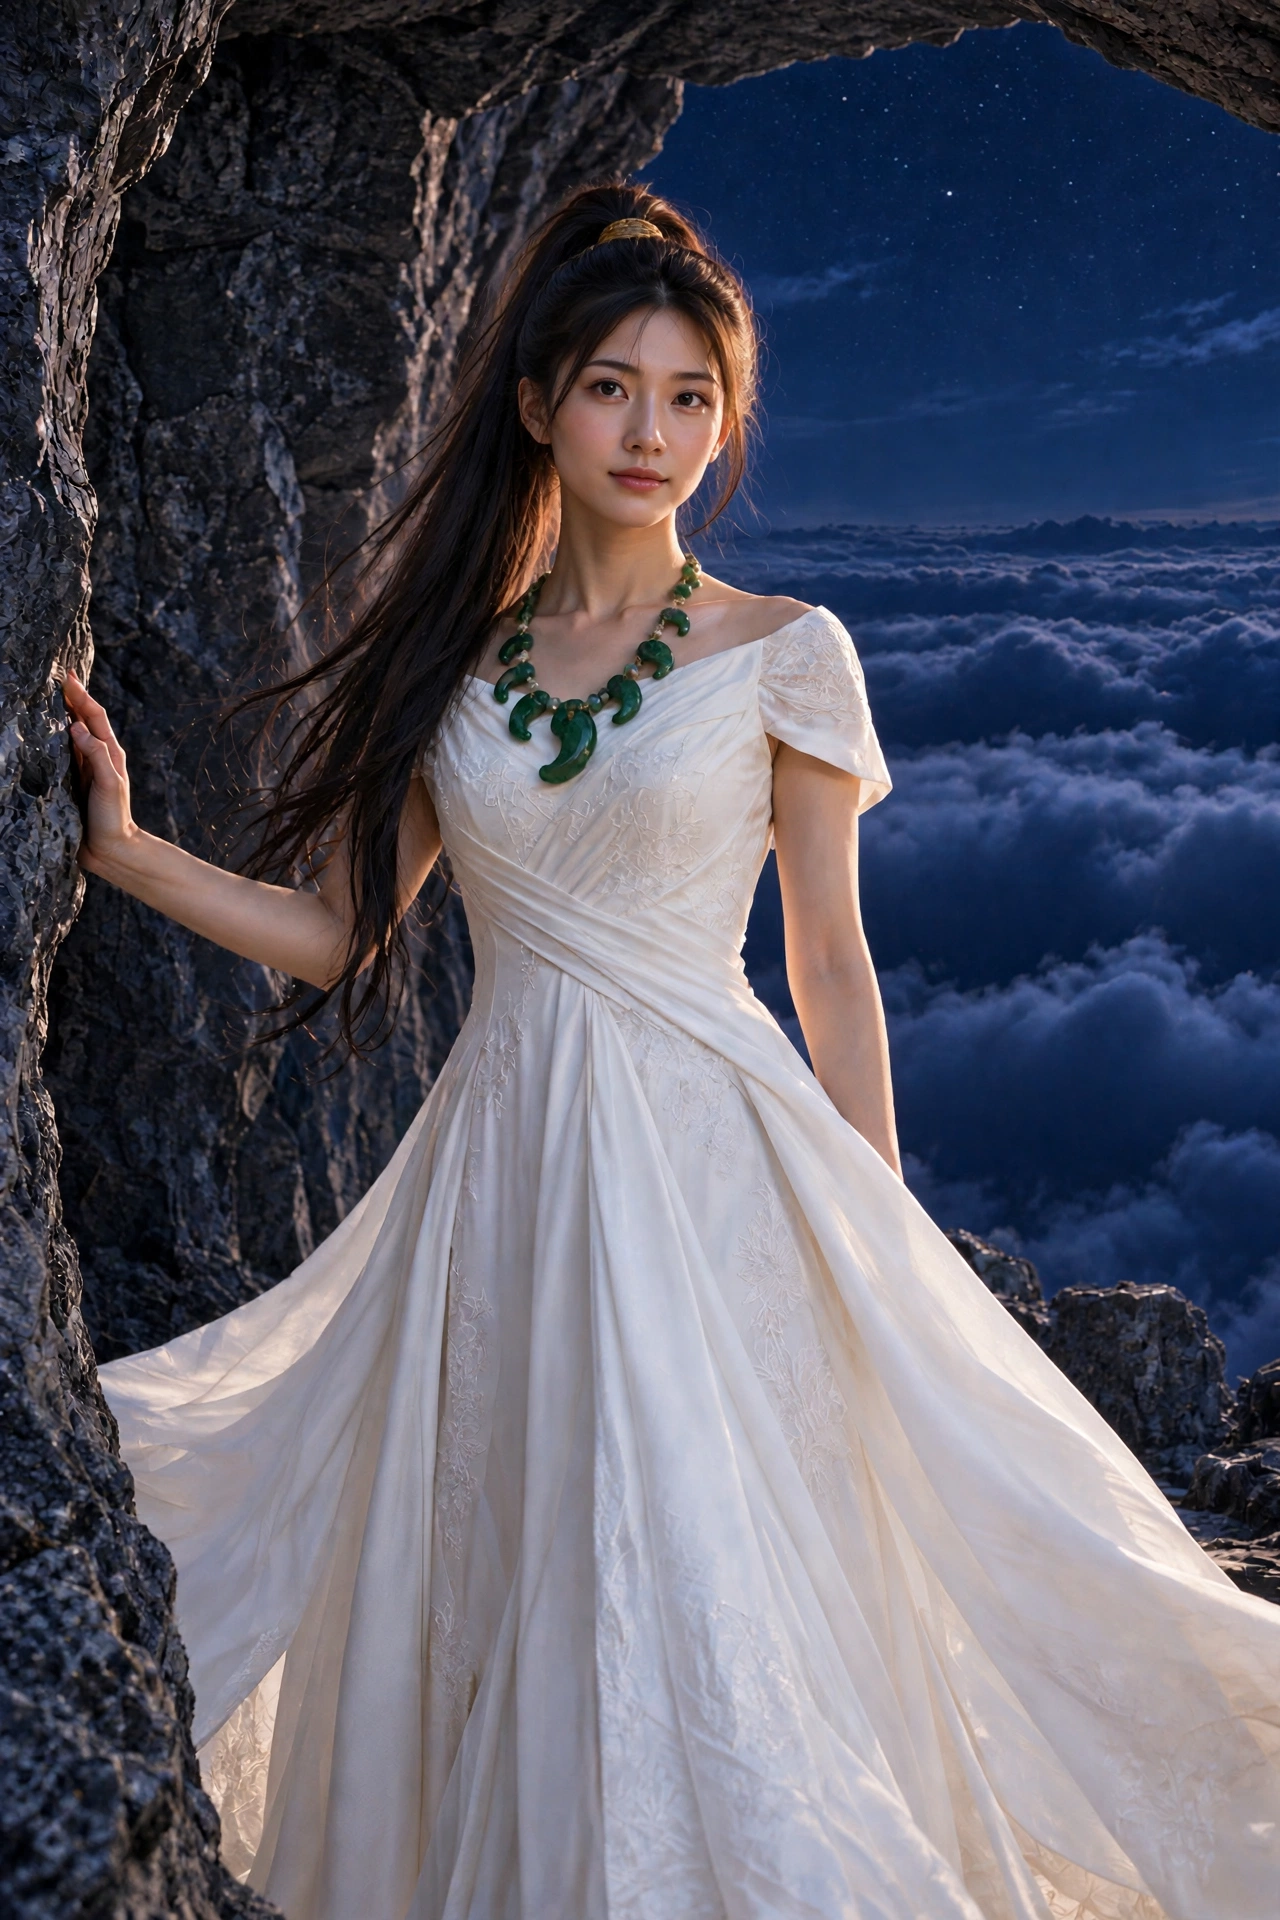
成功。洞窟から日本庭園へ。岩壁に添えていた手の位置に木の幹が配置され、ポーズを変えずに手を添える先が自然に成立したのが特徴。感想:違和感なく完成度は高い。ただし草木がやや多く、手入れされた庭園の「植栽と余白」がはっきりした感じの方が好み。
ポーズ変更
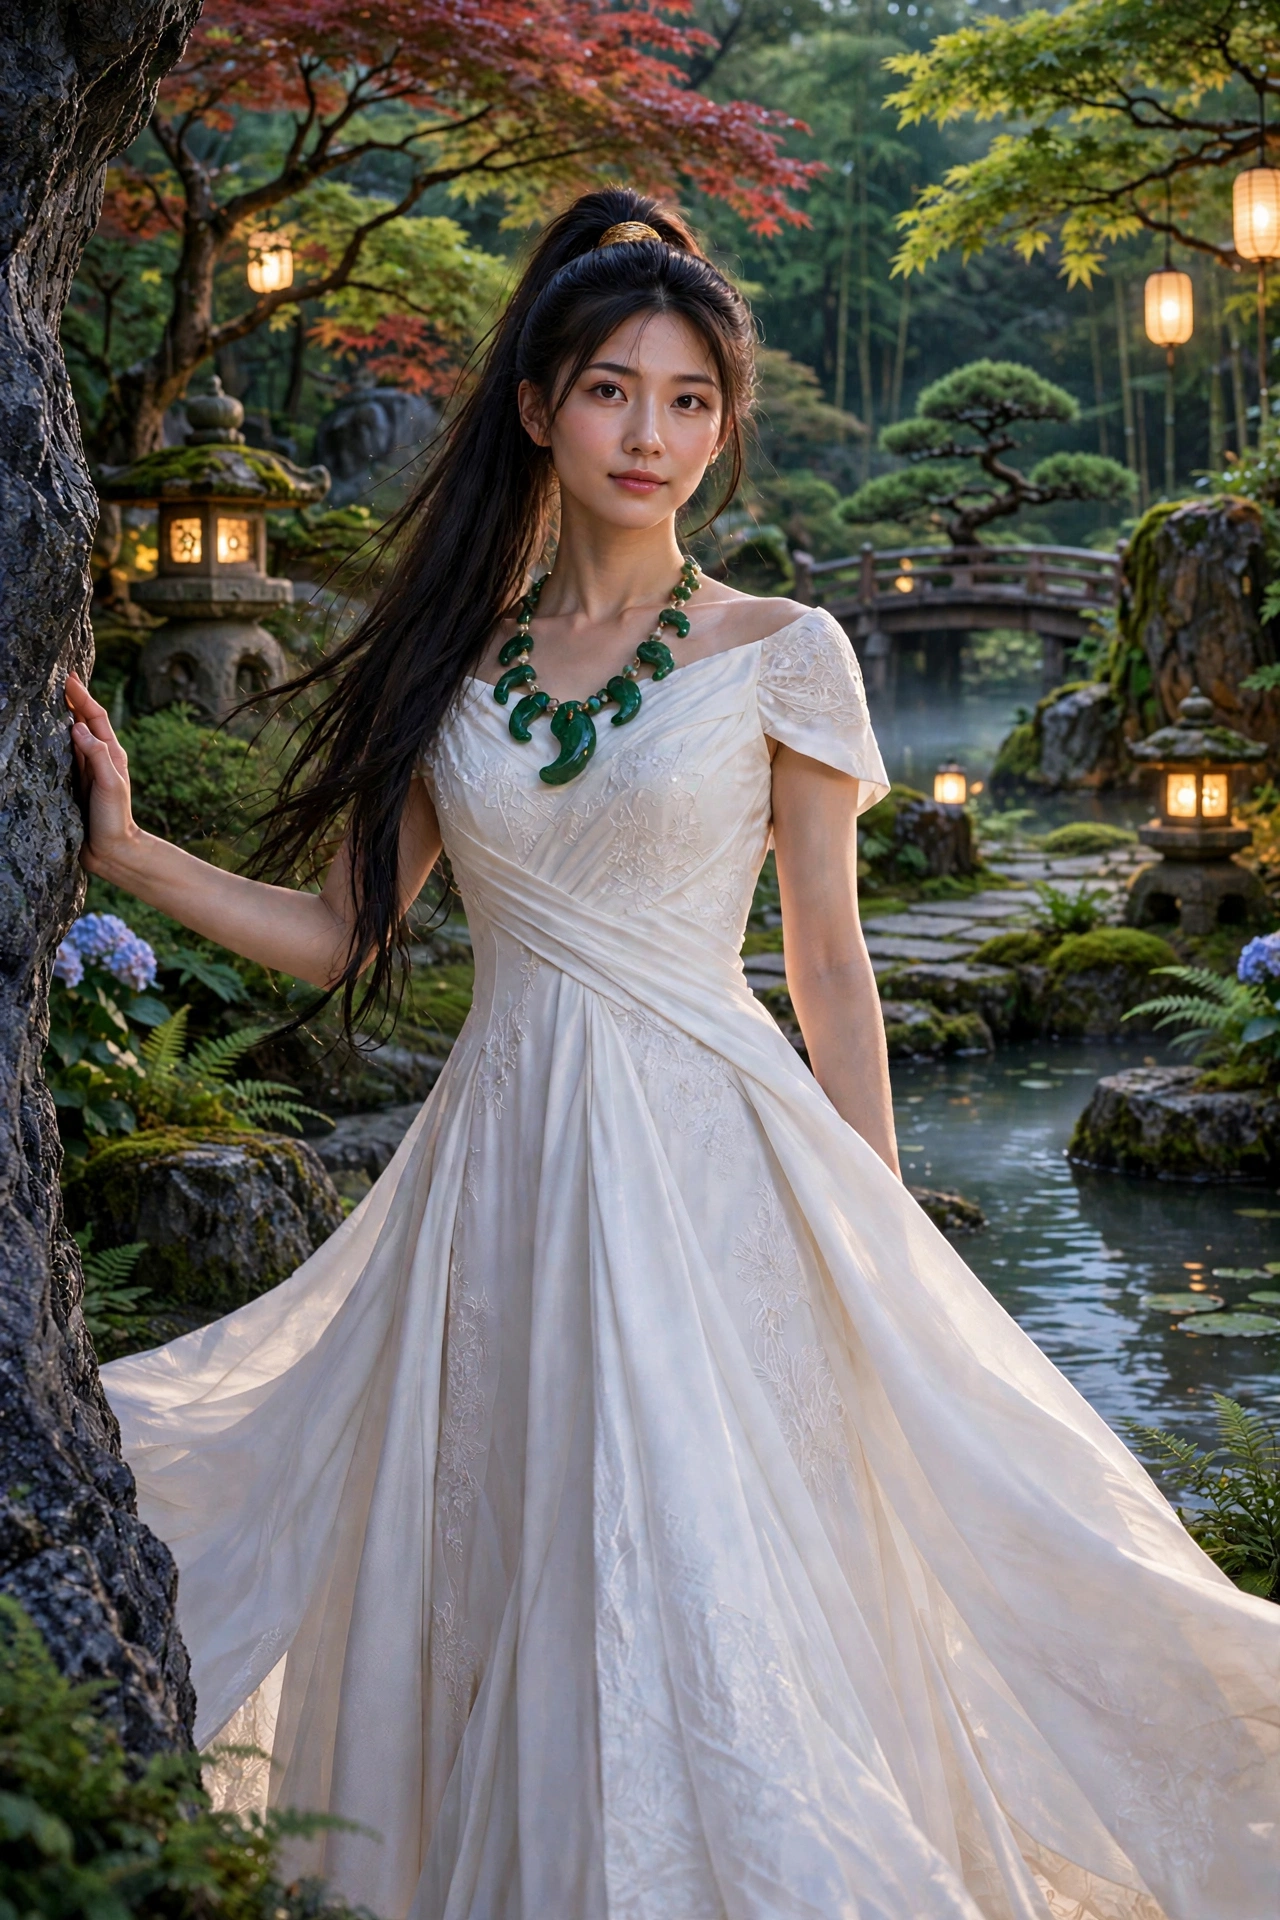
成功。ベンチに座る姿が自然で、ドレスの裾が座り姿に合わせて広がり足元を隠した。感想:Gemini版で気になった裸足が見えず好印象(その分、足や靴の描写精度自体は判断できない)。
表情変更
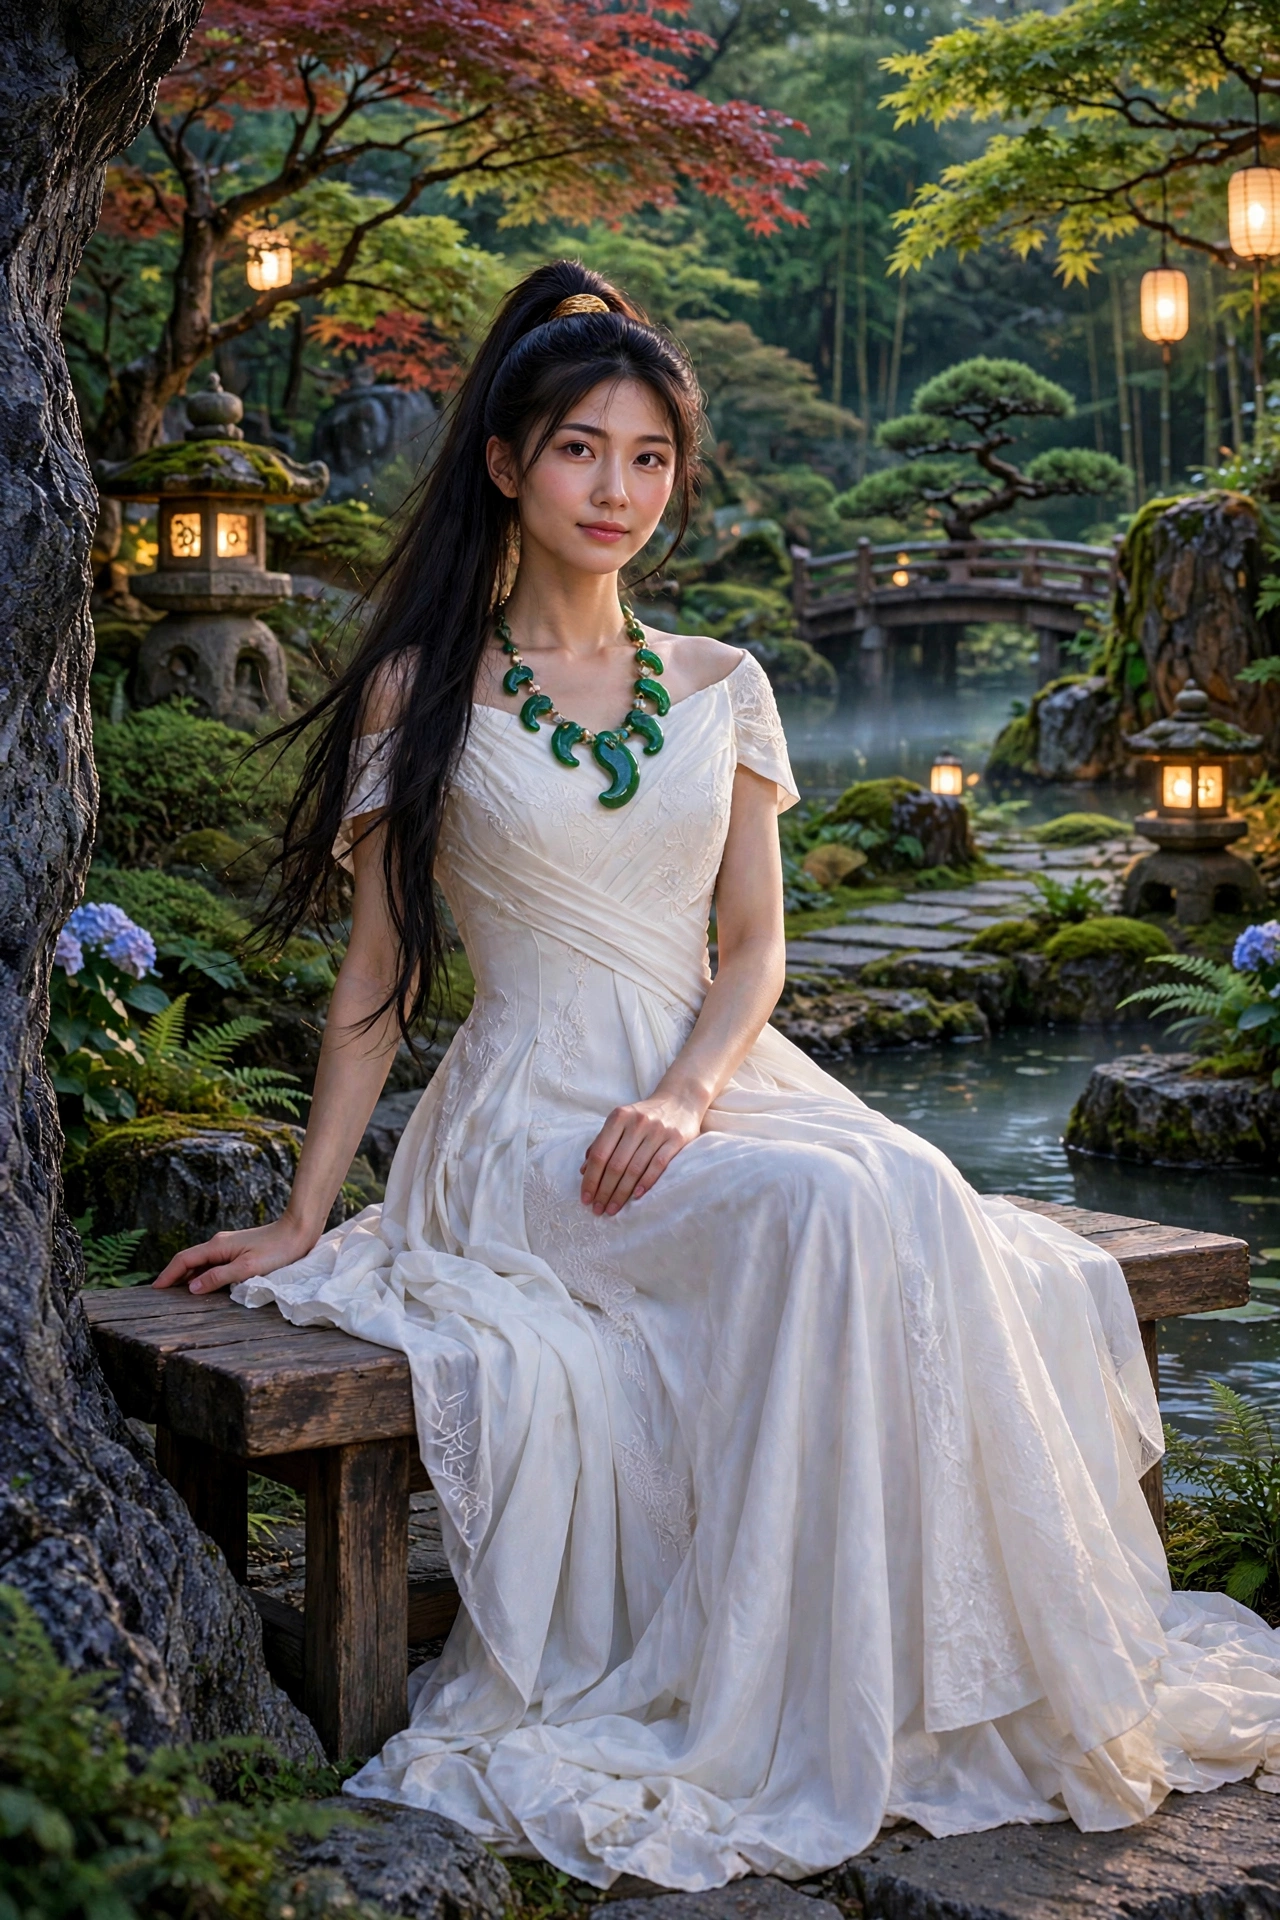
笑顔への変更は成功。ただし歯が見える明るい笑顔で、ChatGPT版・Gemini版の微笑みより強め。Muse自身も生成直後に「指示の『やわらかく』より少し強め」と自己評価していた。
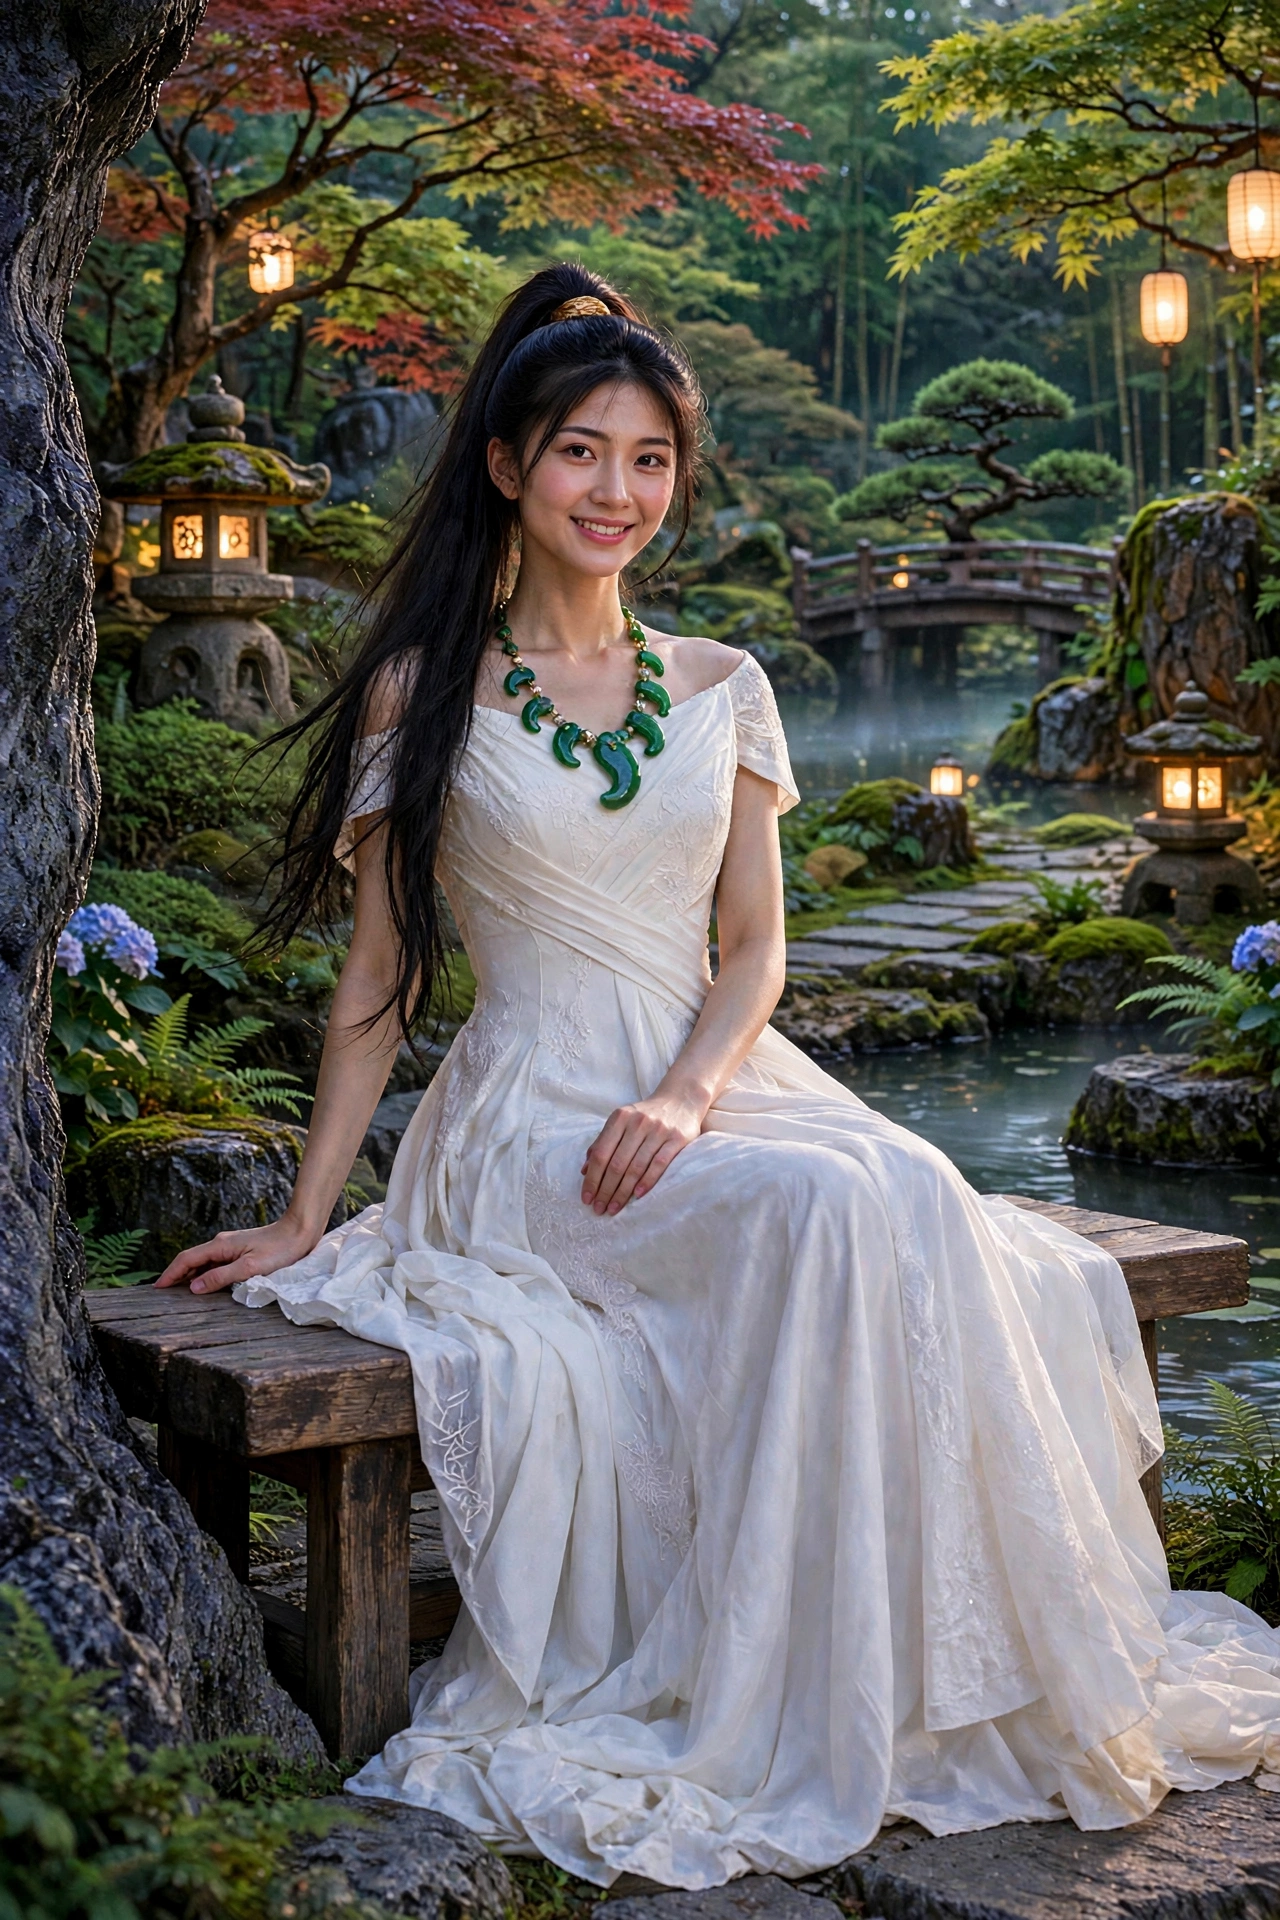
髪型変更
初回で成功。頭頂部の結び目の名残や金の髪留めは残らず、自然なロングストレートに。感想:Gemini版と近い「そのまま下ろした髪」。整い具合の理想にはChatGPT版の最終結果が一番近かった。
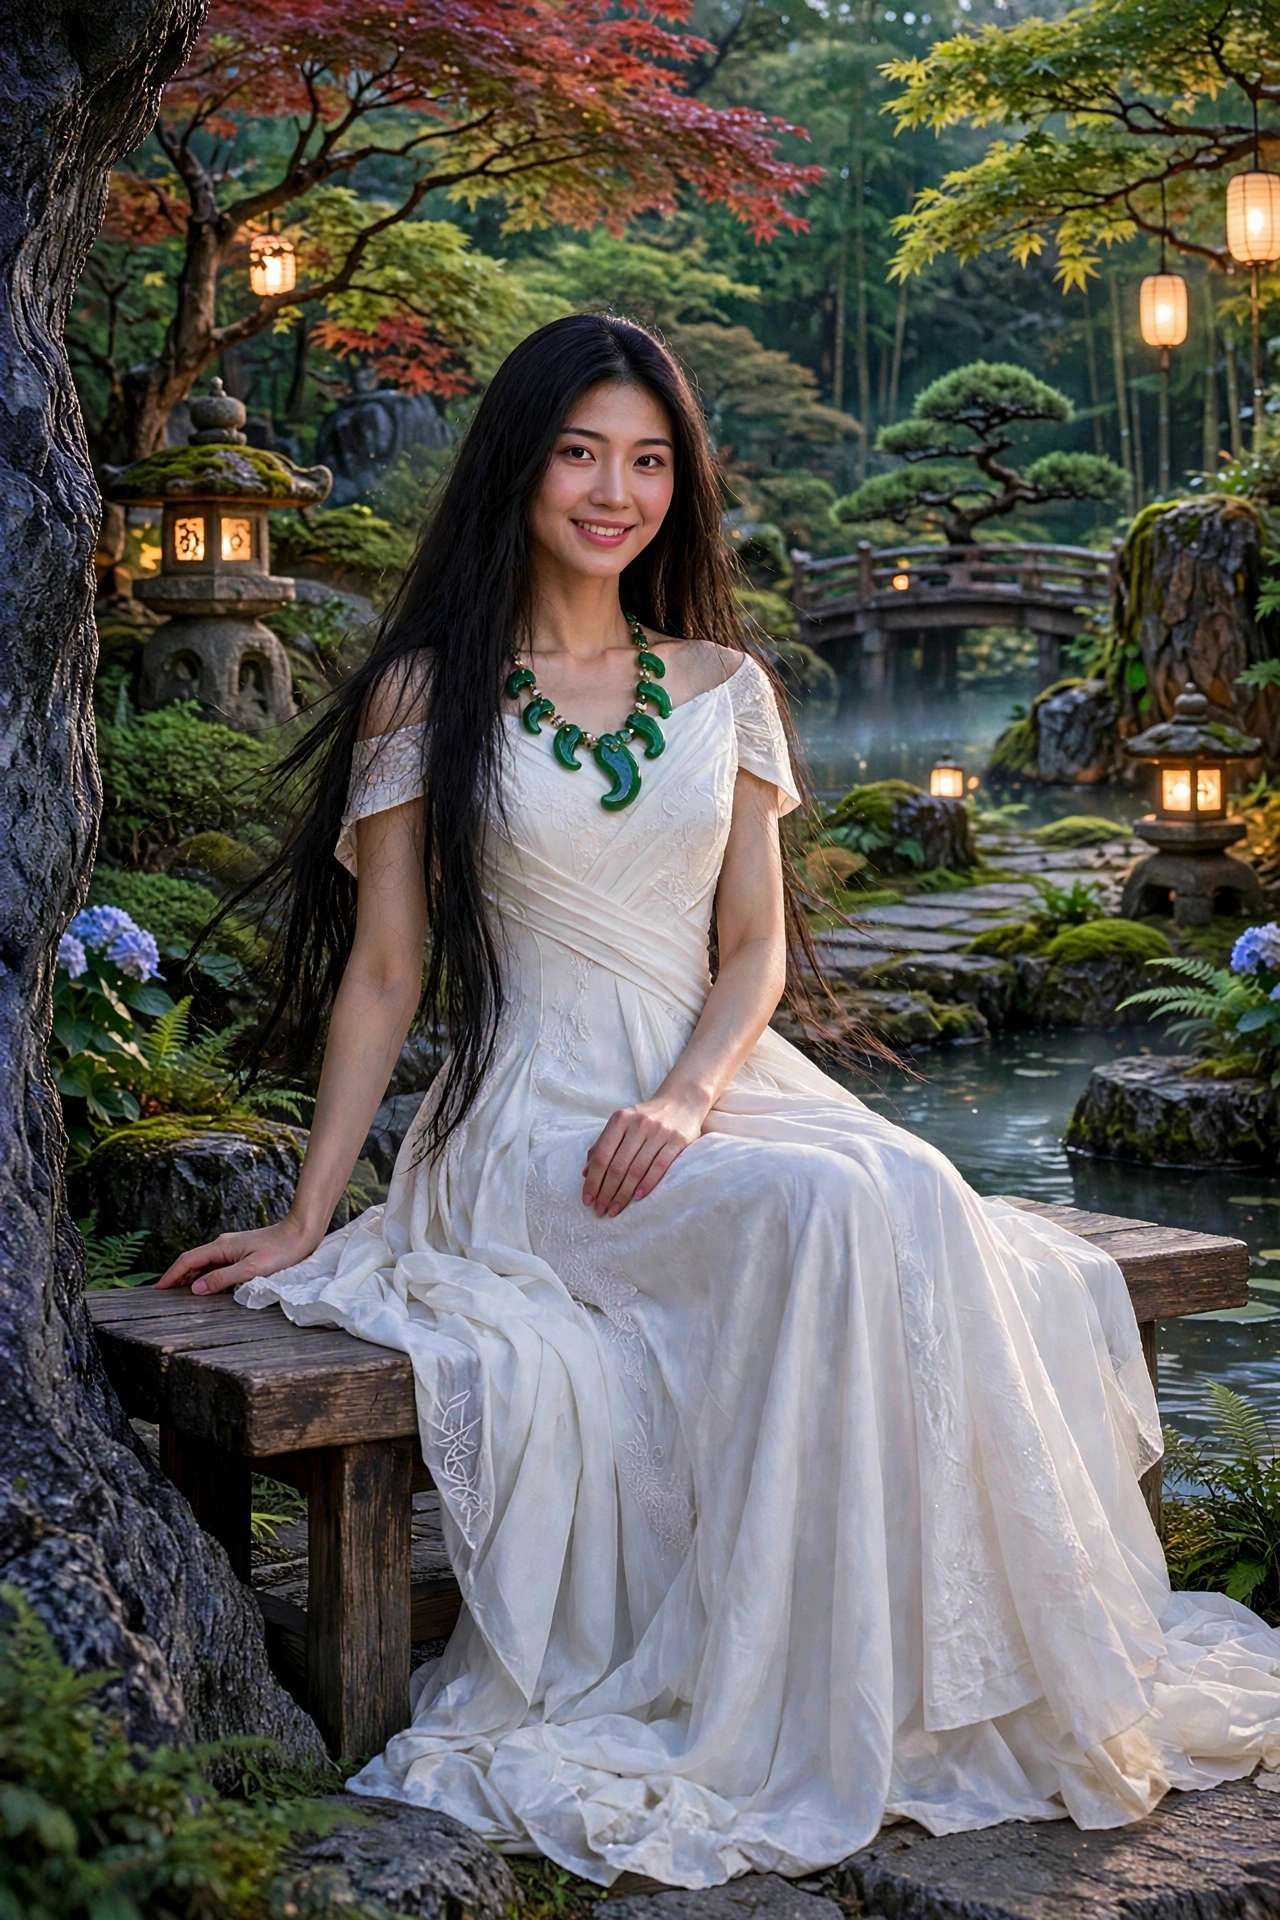
手振り動画
MP4・5.0秒ぴったり・縦長768×1152・カメラ固定。動きは滑らかでカクカク感はなく、池の水面や鯉の表現も自然だった。一方で指示との相違が2点:①振ったのは膝の手ではなくベンチ側の右手で、最後は両手が膝に揃う終わり方になった ②「音声とBGMは入れないで」の指定にもかかわらず小さな音の音声トラックが含まれていた(平均約-44dB)。また元画像と比べると顔の印象に若干の違いを感じた。なおGemini版の動画にも鳥のさえずりや水音が入っており、無音指定が効きにくいのは共通の傾向だった。
3社比較表
| 項目 | ChatGPT | Gemini | Muse |
|---|---|---|---|
| 服装変更 | 成功(首飾りがペンダントに変化) | 成功(勾玉を維持) | 成功(勾玉を維持) |
| 背景変更 | 詳細比較未確認 | 詳細比較未確認 | 木の幹で手の位置を自然に処理 |
| ポーズ変更 | — | 裸足が気になった | ドレスの裾で足元が自然に隠れる |
| 表情変更 | 控えめな微笑み | 柔らかな微笑み | 歯が見える明るい笑顔 |
| 髪型変更 | 初回失敗・再試行で成功 | 初回成功 | 初回成功 |
| 手振り | GIFでカクカク | MP4で自然(約10秒・環境音あり) | MP4で自然(5秒・小さな音声トラックあり、無音版も作成) |
髪型の好み:最終的な整い具合はChatGPT版が最も理想に近い(ユーザー所見)。
感想・気づき
3社とも全工程を完走したが仕上がりの個性ははっきり違う。Muse版の特徴は生成そのものに加えて、各段階での詳細な自己評価と、音声の不一致のような失敗を自ら申告して代替版まで用意する「作業支援」の側面だった。ただし自己評価は生成したAI自身の説明であり、第三者の独立した検証ではない点は留保する。
次に試したいこと
第2回で出た提案「直前の画像だけでなく元画像も途中で見返しながら編集し、顔や小物の変化に早く気づく進め方」は今回も未実施で、今後の候補として残っている。
コメント
良かった点:ChatGPTが作成した同一の指示文を用い、服装・背景・ポーズ・表情・髪型・手振りの5段階編集および動画生成を、Museがすべて再試行ゼロの一発勝負で完走している点です。さらに、各段階でMuse自身が「勾玉が残った」「少し笑顔が強めになった」といった自己評価を下したり、無音指定の不一致を自ら検出して代替の無音版を別途用意したりするなど、単なる生成にとどまらない「プロセスの透明性と誠実さ」が光る検証内容になっています。
気づいた点:ChatGPT版、Gemini版、Muse版という3社のモデルを同じ条件で比較したことで、同じ指示であっても首飾りの変化(勾玉の維持 vs ペンダント化)や笑顔のニュアンス、髪型の整い具合、動画における無音指定の挙動などにそれぞれの「個性」やクセがはっきりと浮き彫りになっている点です。特に、AI自身が生成結果のメタ認知(自己評価)を行うことが、検証記録をより立体的にする上で大きな強みになると気づかされます。
次に試すと面白そうなこと:記事内でも触れられている「直前の画像だけでなく元画像も途中で見返しながら編集し、顔や小物の変化に早く気づく進め方」を実際に導入してみることです。複数段階の編集を経る中でどうしても生じてしまう微細な顔立ちや小物のブレを、元画像をアンカー(基準)にすることでどこまで抑え込めるのか、3社のモデルごとの適性も含めて比較してみたいです。
良かった点:同じ元画像・変更順・指示文で、服装から髪型、手振り動画までを一発生成で比較し、3社の違いを整理している点です。気づいた点:Museは背景変更時に手を添える先を木の幹へ自然に置き換えた一方、無音指定でも音声トラックが含まれ、手を振る位置も指定と異なりました。次に試すと面白そうなこと:直前の画像だけでなく元画像も途中で見返し、顔や小物の変化を早く把握する進め方です。
良かった点は、全段階を再試行0回で完走したこと。背景変更で岩壁に添えていた手の先に木の幹が置かれてポーズが自然に成立した処理と、髪型の初回成功が光る。気づいた点は、表情が指示より強めの笑顔になったことと、手振りで振った手が想定と違ったこと。音声トラックの不一致をMuse自身が検出して無音版まで用意した「作業支援」の側面も面白い。次に試すと面白そうなのは、3社の最終結果を並べて顔の印象の変化を見比べる総括と、元画像を見返しながら進める方法の実践。