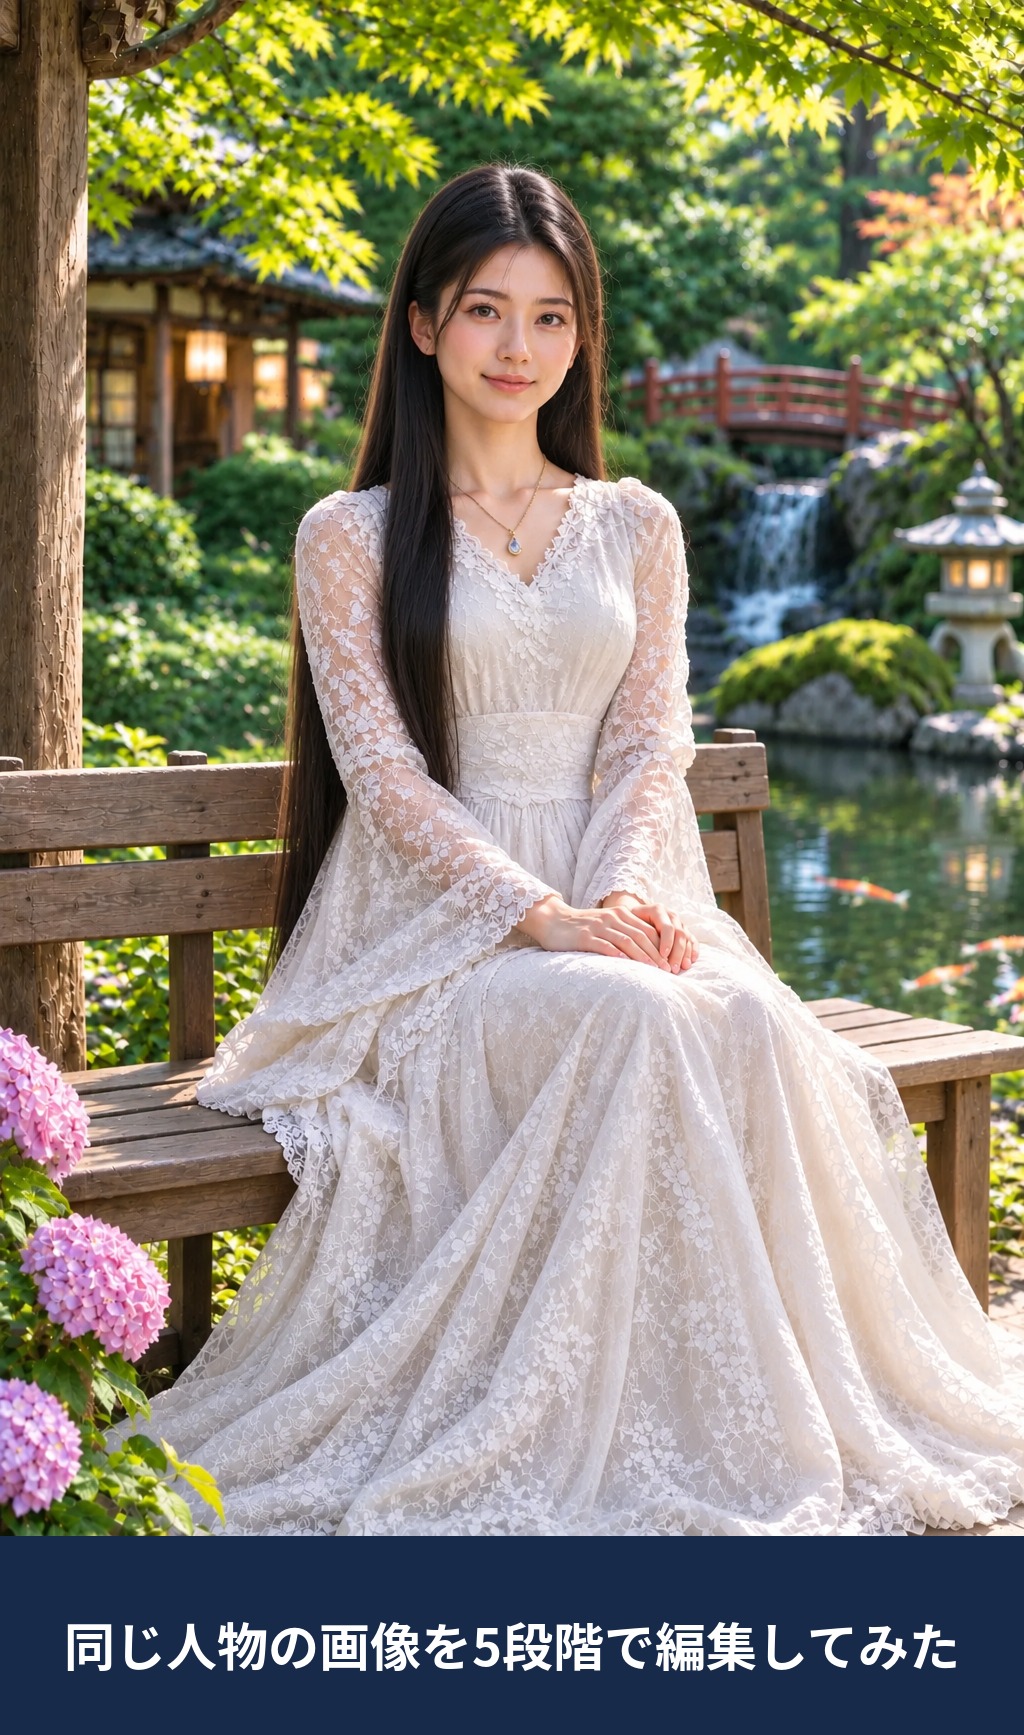
目的
ChatGPTの画像生成・編集機能で、同じ人物の特徴を維持しながら、服装・背景・ポーズ・表情・髪型を1つずつ順番に変更できるか(人物の一貫性と指示への追従性)を確かめる。最後に、完成した静止画からGIFアニメーションを作れるかも試す。もともとは動画作成の一環で始めた検証。
素材
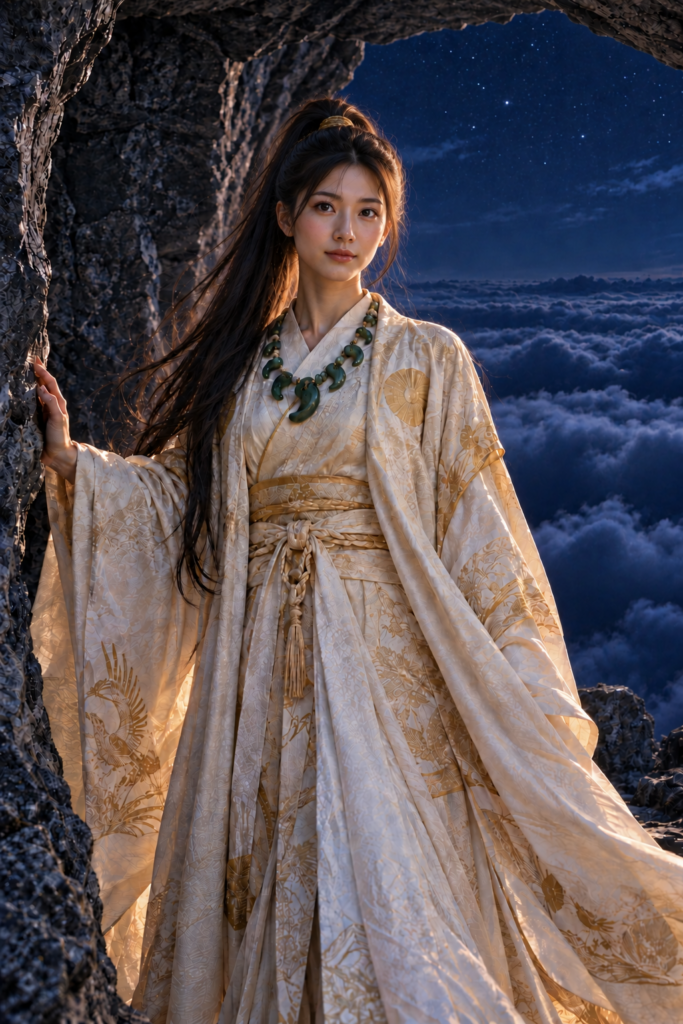
元画像1枚:長い黒髪を高い位置で結んだ女性、クリーム色と金色を基調とする華やかな和装、星が見える幻想的な洞窟と雲海の背景、岩に手を添えて立つ構図。天照大御神をイメージした人物。(実写かAI生成か、生成元は不明)
自分でやったこと
- 元画像の用意
- 変更したい内容の指定
- 各段階で「変更を指示していない要素が維持されているか」の目視確認
- 髪型変更の初回で頭頂部に結んだ髪の名残があることを発見・指摘
- GIFが実際に動いて表示されるかの再生確認と、滑らかさの評価
AIにやってもらったこと
ChatGPTに担当してもらったのは次のとおり。
- 前の段階の画像を基準にした段階的な画像編集・生成(確認できる範囲で静止画は少なくとも6回、GIFは1回)
- 髪型変更では、ユーザーの指摘を受けて「髪を結ばない・結び目や頭頂部の盛り上がりをなくす」と指示を具体化して再生成
- GIF生成後の表示確認の問いかけ
- 検証結果の整理
結果
服装変更(和装→白いレースのロングドレス)
顔や背景をおおむね維持して成功。
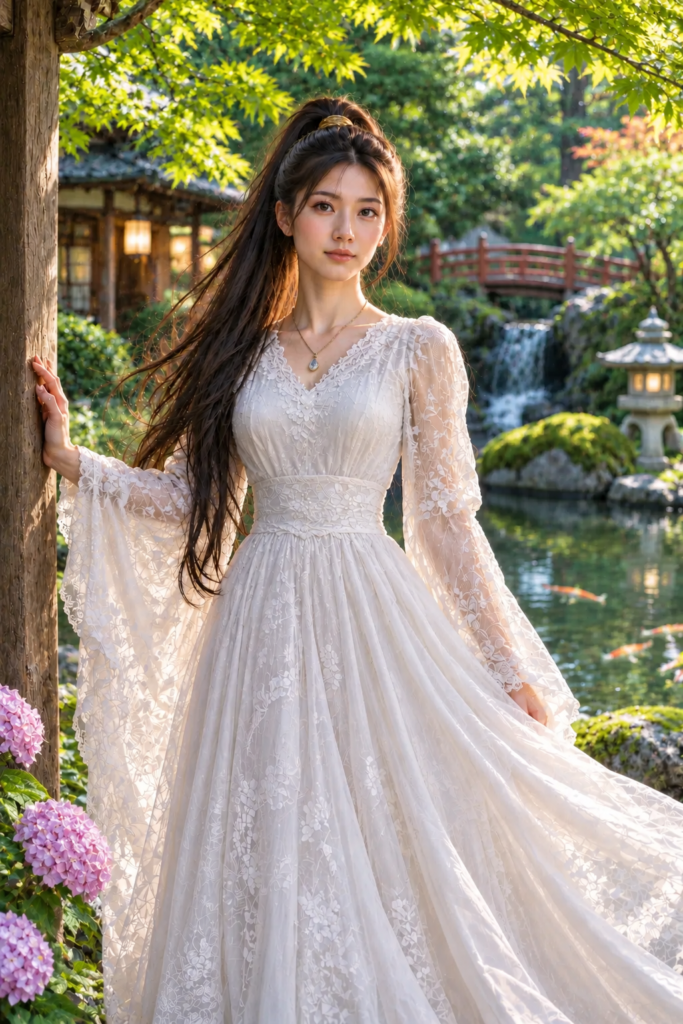
背景変更(洞窟→日本庭園)
赤い橋、池、滝のある日本庭園に変更。人物を維持して成功。
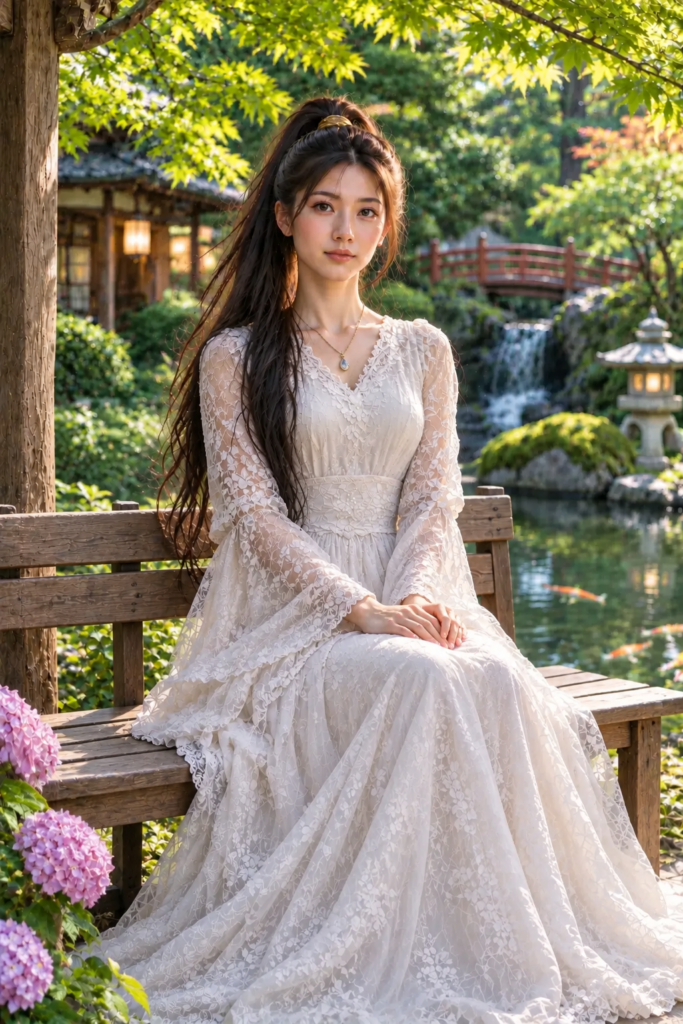
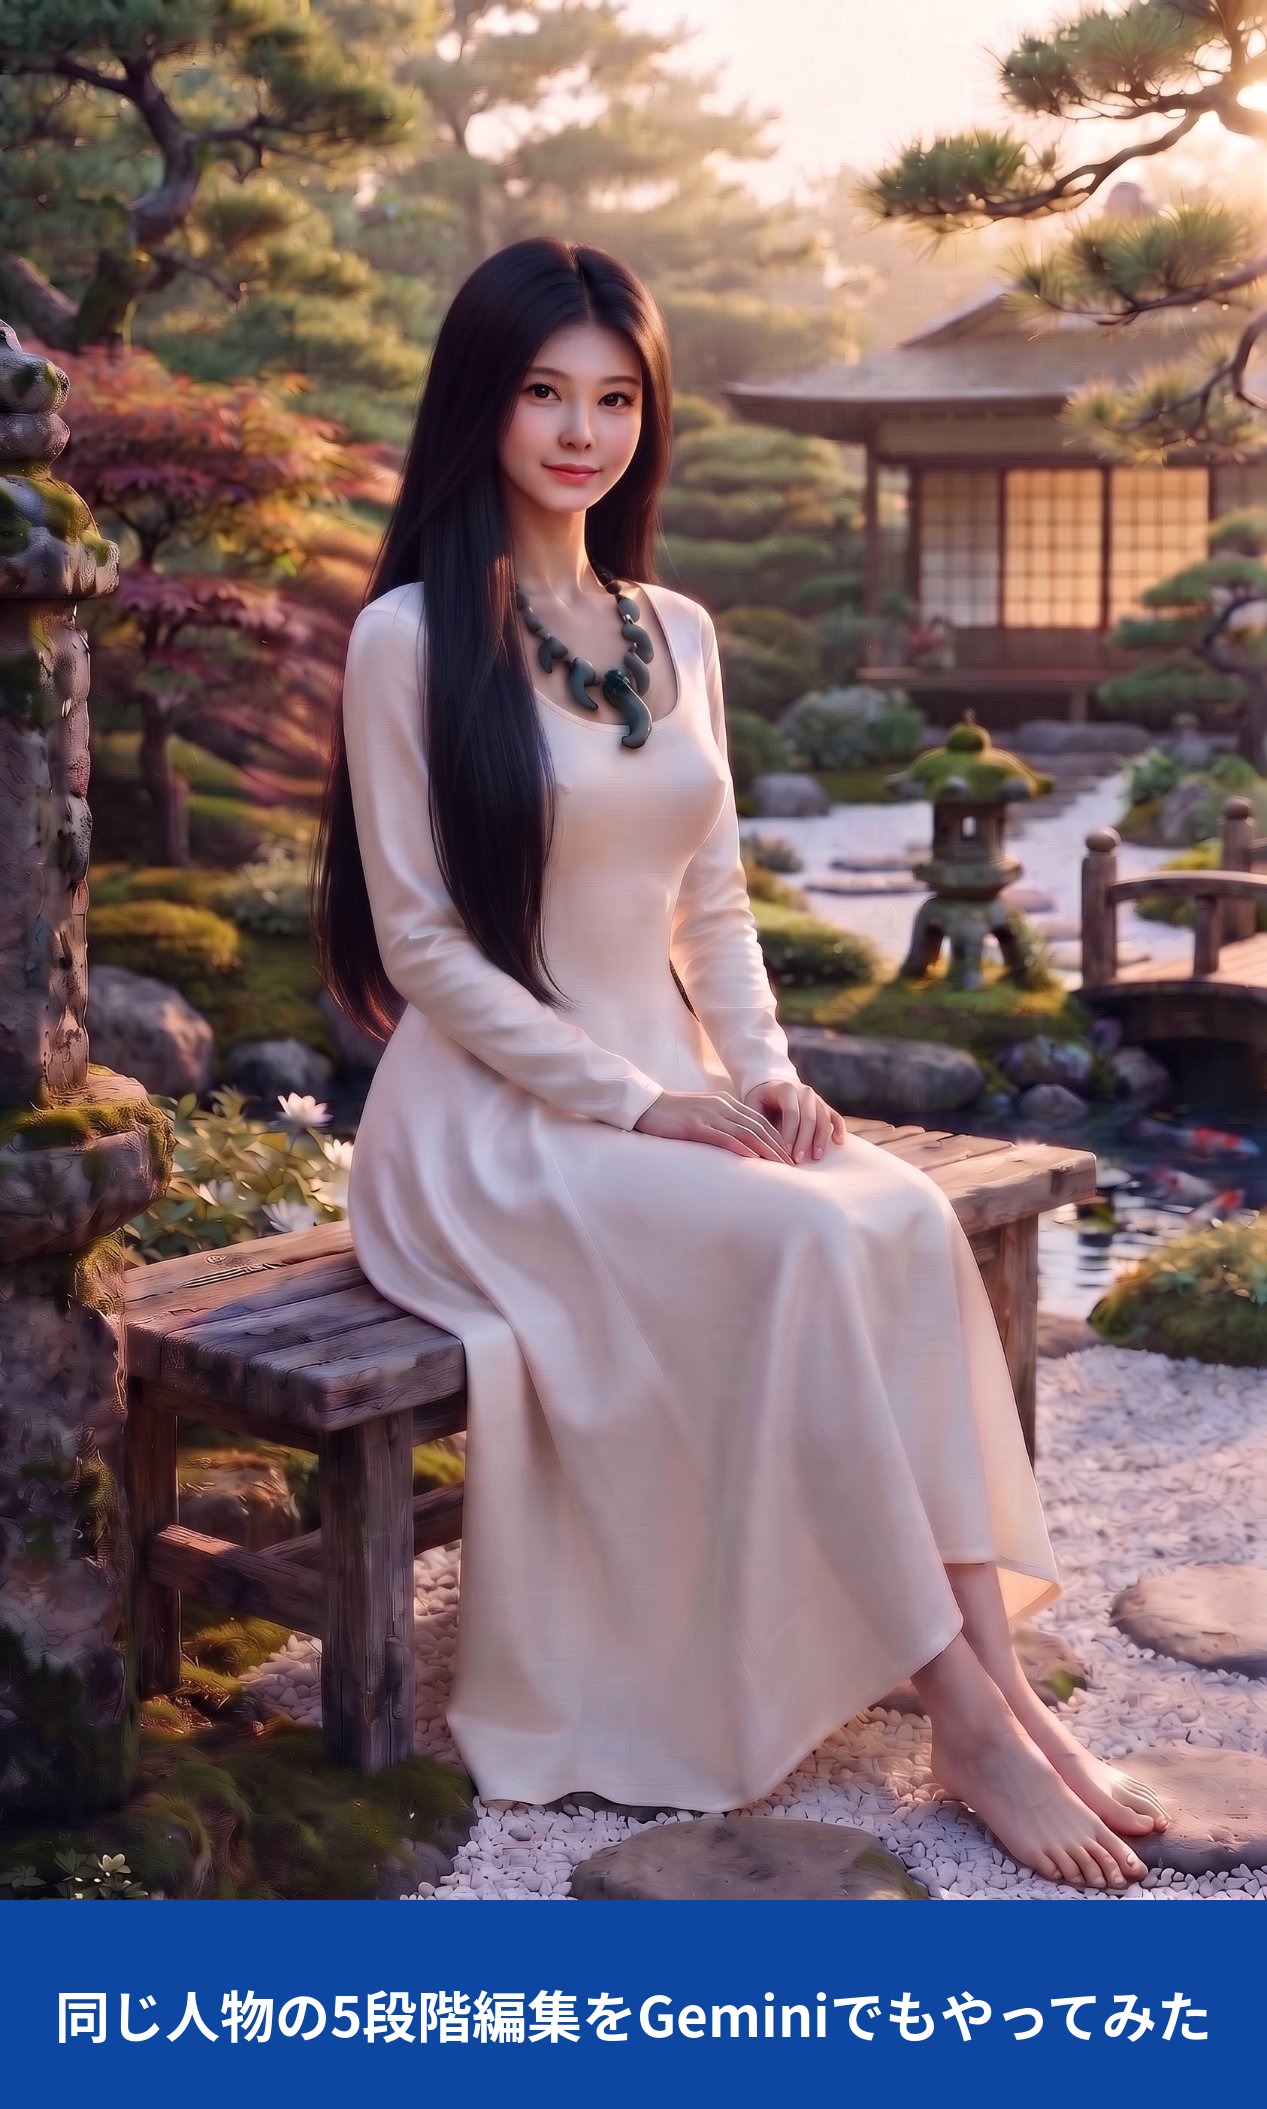
ポーズ変更(立ち姿→庭園のベンチに座る)
同じ人物に見える状態で成功。
表情変更(→自然な笑顔)
成功。
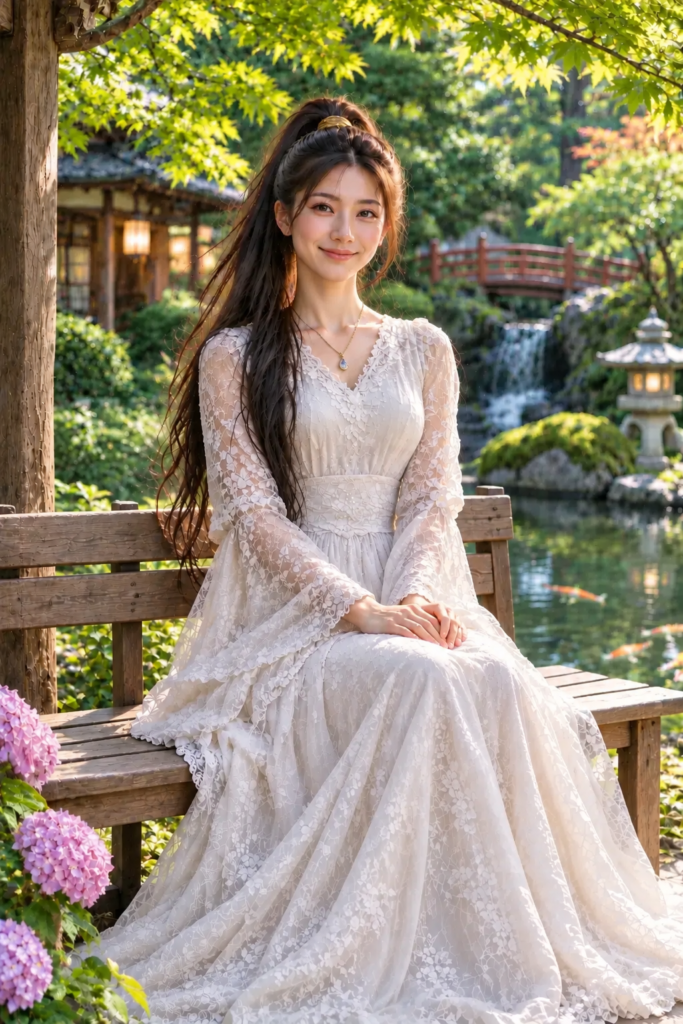
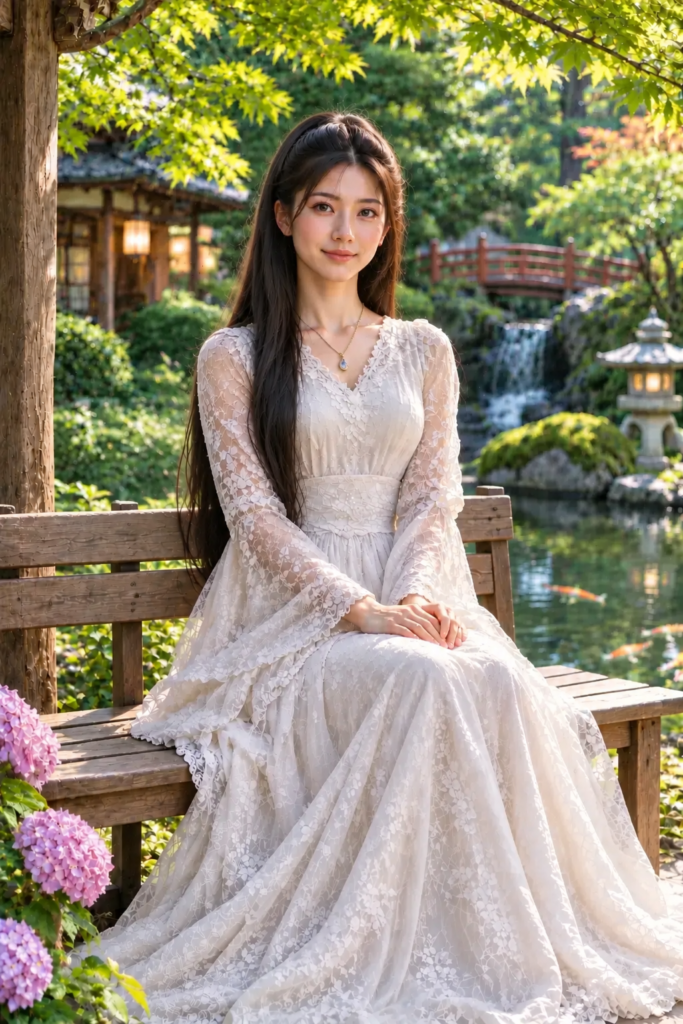
髪型変更(ポニーテール→結び目のない長いストレートの黒髪)
初回は頭頂部に結んだ髪の名残が残って不完全だった。指示を具体化して再試行し、成功。元画像の特徴が意図せず残る具体例になった。
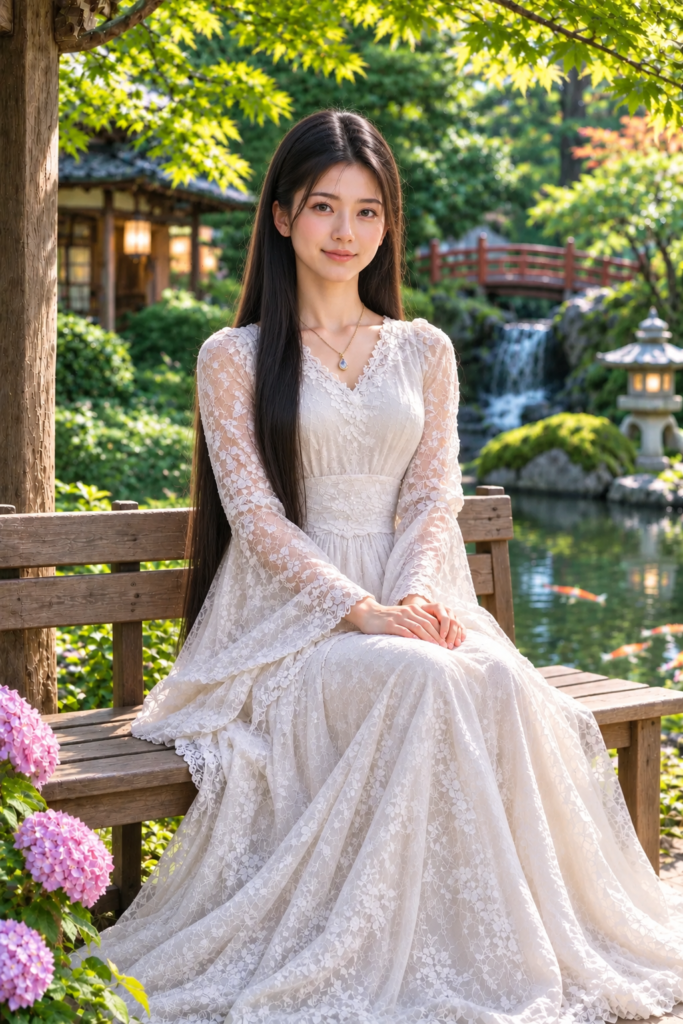
GIF生成(座った人物が笑顔でゆっくり手を振る)
生成と再生は成功したが、動きは「カクカクする感じ」で、一般的な滑らかな動画と同等ではなかった。
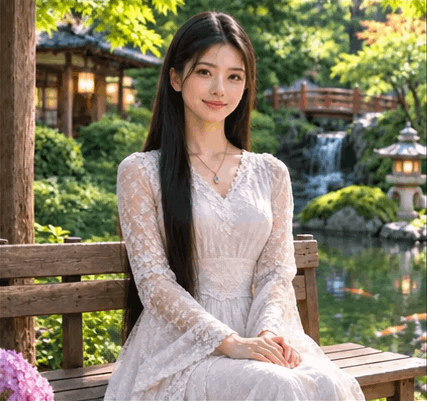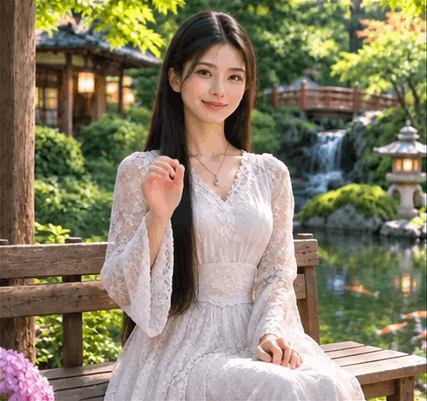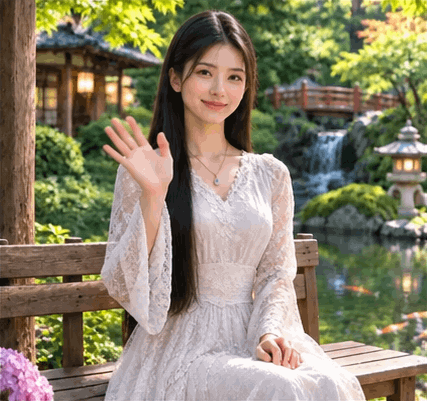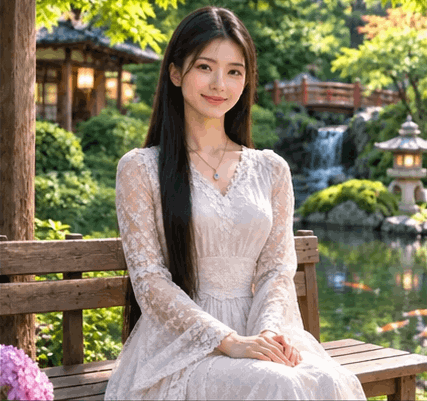
物体の誤認や背景の読み間違いといった事例はなし。人物の一致は目視評価で、数値測定ではない。正確な所要時間とやり取り回数は不明。
感想・気づき
元々は動画作成の一環で始めた検証ですが、指示ごとに変更していく姿が面白かったです。最初の元画像の人物を最後まで維持していくのはお見事でした。
次に試したいこと
Geminiでも同じ元画像・同じ指示文・同じ5項目(服装・背景・ポーズ・表情・髪型)+GIFを試し、結果を比較する記事に発展させる(ChatGPTからの提案。同一条件での比較が条件)。
続編として、Gemini版との比較記事を作成しました:https://aijikkenlog.cloudfree.jp/?p=207
さらに第3回として、Muse版も実施しました:https://aijikkenlog.cloudfree.jp/?p=219
コメント
良かった点:ChatGPTの画像生成・編集機能を活用し、1つの元画像を基準にして「服装→背景→ポーズ→表情→髪型」と1項目ずつ段階的に変更していくという、人物の一貫性と指示への追従性を試す実験設計が非常に明確で素晴らしい点です。特に、髪型変更の際に頭頂部の結び目の名残を見つけてから指示を具体化して再試行するなど、AIとの対話を通じた軌道修正のプロセスがリアルに記録されている点が光っています。
気づいた点:段階的に編集を重ねることで元の雰囲気を保ちつつ見事に変身させていく一方で、髪型の変更初回のように「元の情報(結び目)が意図せず残ってしまう」というAI編集特有のクセや、最後のGIF生成における「カクカクとした動き」など、静止画編集とアニメーション化のそれぞれの限界や特性が具体的に浮き彫りになっている点です。
次に試すと面白そうなこと:記事の結びにもある通り、まったく同じ元画像・同じ指示文・同じ変更項目を用いて、GeminiやClaudeといった他のAIモデルでも同様に5段階編集を行い、モデルごとの「変化のさせ方グセ」や「一貫性の保ち方の違い」をさらに深くクロス比較していく展開です。(※すでに続編としてGemini版やMuse版も公開されているとのことですので、それぞれのモデルがどのような解釈の違いを見せたのか、全体の比較結果をまとめて眺めてみるのがとても面白そうです)
良かった点は、同じ人物を服装・背景・ポーズ・表情と1つずつ変えていく姿が面白く、4段階まで一発で成功したこと。髪型の初回失敗から指示を具体化して再試行で成功した過程も、記録として価値がある。気づいた点は、手振りGIFの動きがカクカクで動画としては物足りないことと、首飾りがペンダントに替わってしまったこと。次に試すと面白そうなのは、髪型の「結び目の名残」のような意図しない残存を、指示文のどの言い回しが防げるか試すこと。
良かった点:一度に多くを変えず、変更しない要素が保たれるかを各段階で目視確認している点です。気づいた点:髪型変更では結び目の名残が残り、指示を具体化して再生成する必要がありました。また、GIFは生成・再生できても滑らかな動画とは異なる動きでした。次に試すと面白そうなこと:同じ素材と条件を他のAIにも渡し、人物の一貫性や指示への追従を比較することです。